目次
同僚との会話で、「夏休みの自由研究をブログ記事にするのは面白そう」という話になりました。題材を探す中で、ミニLLMを作る技術書や雑誌記事を見つけ、実際に作ってみることにしました。
今回は雑誌の「ミニLLM」作成記事を参考に、夏目漱石の1作品で学習した場合と、3作品に増やした場合を比べる実験を夏休みの自由研究としてまとめてみました。
(弊社は7月〜9月の間で任意に夏休みを取る制度なので、本記事も夏の自由研究ということにします)
今回実施した実験では、出力が文章らしくなっていく一方、学習を続けると検証損失が悪化する様子も見られるなど興味深い結果が確認できました。
概要
参考にした記事では『吾輩は猫である』を学習した上で「吾輩は」から「猫である」を出力できるかというものでした。
そこで自由研究として、まずは記事を参考に『吾輩は猫である』を学習するミニLLMを作成。次に『坊っちゃん』『こころ』を加えた3作品でも学習を行い、学習する文章を増やすことで生成結果や損失にどのような違いが出るのか比較してみます。
学習教材には青空文庫のテキストを使いました。
作成したミニLLMの処理概要
処理の全体像
今回作成したミニLLMの処理の流れは以下のとおりです。
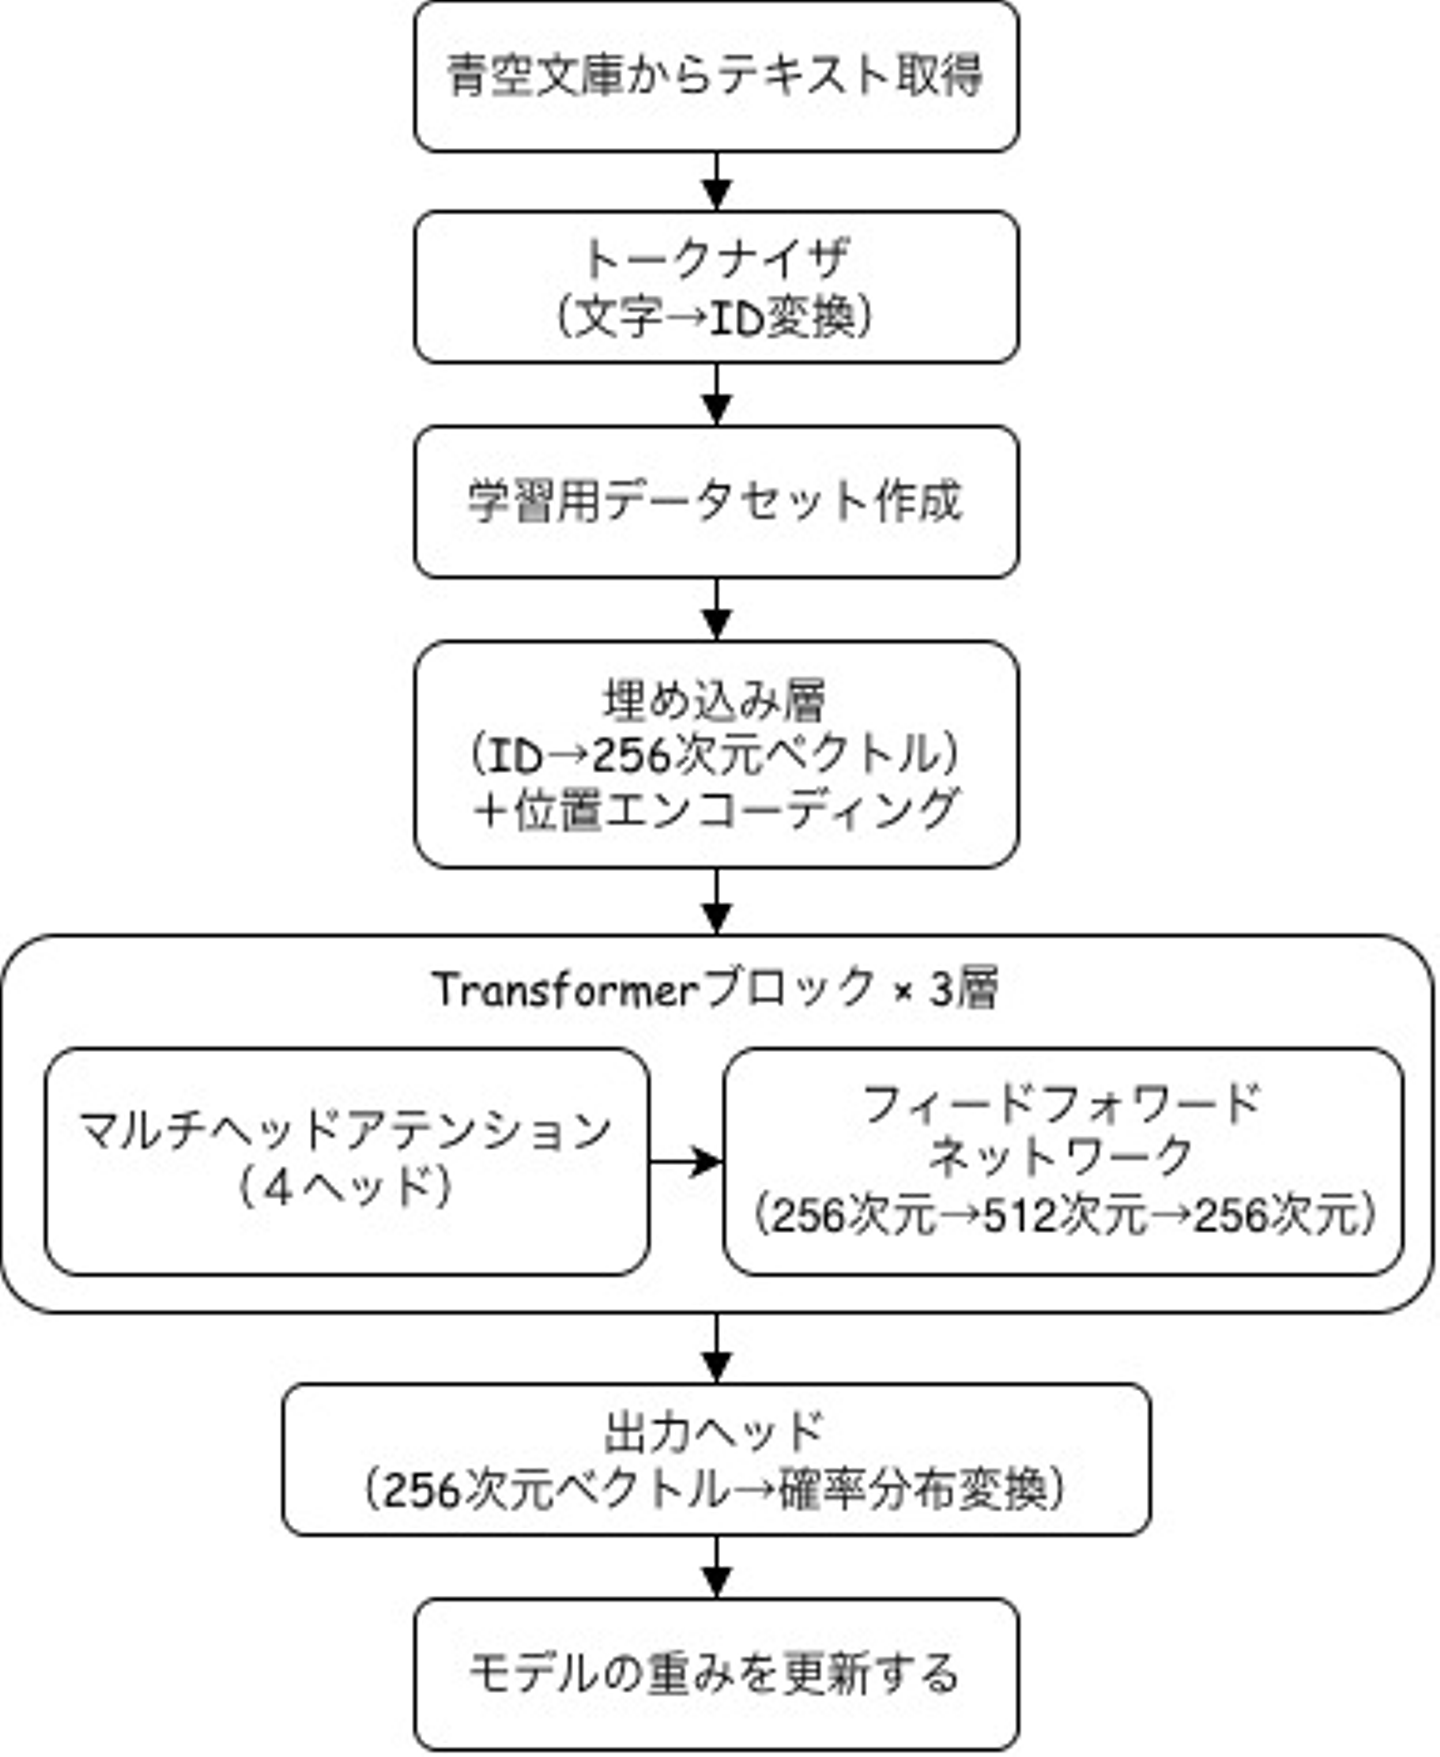
トークナイザ
モデルで文章を処理できるように文字列を数値列に変換します。この変換を担うのがトークナイザです。
今回は、1文字を1トークンとして扱う方法を用いています。教材に登場する文字を集め、それぞれにIDを割り当てるよう処理します。
class CharTokenizer:
    """文字レベルトークナイザ"""
    def __init__(self, text):
        # テキストに含まれるユニークな文字を抽出してソート
        chars = sorted(set(text))
        # 特殊トークンを先頭に追加する
        # PAD:パディング(系列長を揃えるためのトークン)
        # UNK:未知文字
        self.vocab = ["<PAD>", "<UNK>"] + chars
        self.vocab_size = len(self.vocab)
        # 双方向の変換辞書を作成
        self.char_to_id = {c: i for i, c in enumerate(self.vocab)}
        self.id_to_char = {i: c for i, c in enumerate(self.vocab)}
学習用データセット作成
入力が「吾輩は猫であ」なら、正解は「輩は猫である」です。各位置で、それまでの文字から次の1文字を予測するように学習します。開始位置を1文字ずつずらして、重なりのある学習サンプルを作ります。
def __getitem__(self, idx):
    # 入力:位置idxからseq_len文字
    x = self.data[idx : idx + self.seq_len]

    # 正解:入力を1文字ずらしたもの
    y = self.data[idx + 1 : idx + self.seq_len + 1]

    return x, y
埋め込み層
トークナイザで変換した文字IDから、256次元のベクトルを取り出します。
各文字を表すベクトルは、次の文字の予測に役立つよう、学習中に更新されます。
位置エンコーディング
埋め込み層でのベクトル変換だけでは、文字がテキストのどの位置にあるのかがわからないため、文字の位置に対応するベクトルを割り当て、文字ベクトルに足し合わせることで位置の情報も持ちます。
Transformer
Transformerブロックには、マルチヘッドアテンションとフィードフォワードネットワークの処理があります。
マルチヘッドアテンションは文字同士の関係を調べ、フィードフォワードネットワークは、その結果を各位置で加工します。
ミニLLM
文字IDをベクトルに変換し、位置情報を加えてTransformerに渡します。
未来の文字を見ながら答えを予測しないよう、因果マスクで参照範囲を制限しています。出力層では、次の文字の候補ごとにスコアを計算し、正解とのずれを損失として求めます。
def forward(self, idx, targets=None):
    B, T = idx.shape
    device = idx.device

    # 各位置から、未来の文字を参照できないようにする
    mask = torch.tril(
        torch.ones(T, T, device=device)
    ).view(1, 1, T, T)

    # 文字のベクトルに、位置のベクトルを足す
    tok_emb = self.token_embedding(idx)
    pos_emb = self.position_embedding(
        torch.arange(T, device=device)
    )
    x = self.dropout(tok_emb + pos_emb)

    for block in self.blocks:
        x = block(x, mask)

    # 各位置について、語彙内の各文字のスコアを出す
    logits = self.lm_head(self.norm(x))

    loss = None
    if targets is not None:
        loss = F.cross_entropy(
            logits.view(-1, logits.size(-1)),
            targets.view(-1)
        )

    return logits, loss
文字列生成処理
最後の位置のスコアを確率に変換し、その確率に従って次の1文字を選びます。
選んだ文字を入力の末尾に追加し、同じ処理を繰り返すことで文章を生成します。
今回の生成処理では、過去に生成した2〜4文字の並びが再び現れそうな場合に、その並びを完成させる文字のスコアを下げることで、同じ表現の繰り返しを抑えています。
def generate(model, tokenizer, prompt, device, max_new_tokens=100,
             temperature=0.8, top_k=10,
             ngram_penalty=10.0, ngram_sizes=(2,3,4)):

    for _ in range(max_new_tokens):
        # 直近のコンテキストから、次の文字のスコアを計算
        logits, _ = model(tokens[:, -model.max_len:])
        # 最後の位置のスコアを取り出し、選び方のランダムさを調整
        logits = logits[:, -1, :] / temperature

        # 過去に出てきた2〜4文字の並びが再び選ばれる候補のスコアを下げる
        if ngram_penalty > 0:
            for n in ngram_sizes:
                if len(token_list) >= n:
                    suffix = tuple(token_list[-(n-1):]) if n > 1 else ()
                    for pos in range(len(token_list) - n + 1):
                        if tuple(token_list[pos:pos+n-1]) == suffix:
                            logits[0, token_list[pos+n-1]] -= ngram_penalty

        # スコアの高い候補に絞る
        if top_k:
            v, _ = torch.topk(logits, top_k)
            logits[logits < v[:, [-1]]] = float("-inf")

        # 確率に変換して1文字を選び、入力の末尾に追加
        next_tok = torch.multinomial(F.softmax(logits, dim=-1), 1)
        tokens = torch.cat([tokens, next_tok], dim=1)
        token_list.append(next_tok.item())
実験結果
プロンプトとして「吾輩は」を入力し、以降の文章を予測した結果を確認していきます。
モデル学習の基本設定は、二つの実験で揃えました。
- コンテキスト長:128文字
- バッチサイズ:32
- 学習数:40エポック
※1エポックは、学習データ全体を一巡する単位です。そのため、両実験とも40エポックですが、学習中に処理するデータ量は異なります。
事前確認:未学習状態の出力を確認する
学習前はただの文字の羅列になっています。
プロンプト:「吾輩は」
学習前の出力:「吾輩は祈主店恍円た哀梅言哀可臆鑼2英祈伯金祈碌廓芳己兄禍主飄続縁狆抗難鏡傷祈好梅欧傷○な健佯根鼓化金真郎限」
学習データについて
青空文庫の本文を文字の並び順を保ったまま分割し、先頭90%を訓練データ、末尾10%を検証データにしました。訓練データはモデルの学習に、検証データは重みの更新には使わず、各エポック終了後の予測性能の確認に使います。
実験1:『吾輩は猫である』だけで学習する
『吾輩は猫である』だけを使い、40エポックの学習を行いました。
まず、生成文の変化を見てみます。
学習初期:1エポック
吾輩はさな」「いる。「あな。あるかないます、まった」と見たとなか」
「どっませっ
句読点やかぎ括弧は現れていますが、文字のつながりが不自然で、意味を読み取るのは難しい状態です。
学習途中:10エポック
吾輩は主人間になって、ある。あの方爵だがね」と云う。「そんです。ころか」「なるか「主人」「云う」などの語や、会話文らしい形が現れました。ただし、「主人間になって」のように語のつながりが不自然で、文全体の意味はうまくつながっていません。
学習後半:24エポック
吾輩は少々同時間を四十年修業したくらい。「近頃さあ」「なに大丸でも何を出すかして「四十年修業したくらい」のような文章っぽい表現や、会話文らしい形が現れました。ただし、「少々同時間を四十年修業した」のように、文全体としては意味がつながっていません。
学習終了:40エポック
吾輩はこの際限られている。「そうおっしゃるんですよ。帽子は全体あの上って、どいま「そうおっしゃるんですよ」のように、短い範囲では自然に読める表現が現れました。
一方で、その前後の文意はつながらず、40エポックの学習後も、文章全体の一貫性には課題が残っています。
実験2:学習内容を3作品に増やす
3作品を使い、40エポックの学習を行いました。
学習初期:1エポック
吾輩はそれためた。その前のを聞きた私の気のの方はおれもい。
 おの父のおりしたら
「私」「父」などの語は現れていますが、文字のつながりが不自然で、意味を読み取るのは難しい状態です。
学習途中:10エポック
吾輩はこの言葉を眺めた。私は何かにもなかったが、自分がまたしないのという事実には「吾輩はこの言葉を眺めた。」のように、短い範囲では自然に読める文が現れました。ただし、続く文章の意味はうまくつながっていません。
学習後半:24エポック
吾輩はその後どうであった。しかしそれでもまたこういう理屈な父の方が剣呑さいといっ「吾輩はその後どうであった。」のように、短い範囲では文章として読める部分が現れています。一方で、続く「こういう理屈な父の方が剣呑さい」のような表現は不自然で、文全体の意味はうまくつながっていません。
学習終了:40エポック
吾輩はこの生きている私には、それ以上の間に合えない事はなかった。しかし先生の奥さ文章らしい形にはなっていますが、「吾輩はこの生きている私には」のように、人称や文の構造が不自然な部分が残っています。生成例を見る限り、学習を長く続けるだけで、文章全体の一貫性が得られるわけではありませんでした。
数字から見る、二つの実験の違い
学習中は、以下の指標を記録しました。
どの指標も正解の文字に高い確率を付けられるほど値が小さくなります。
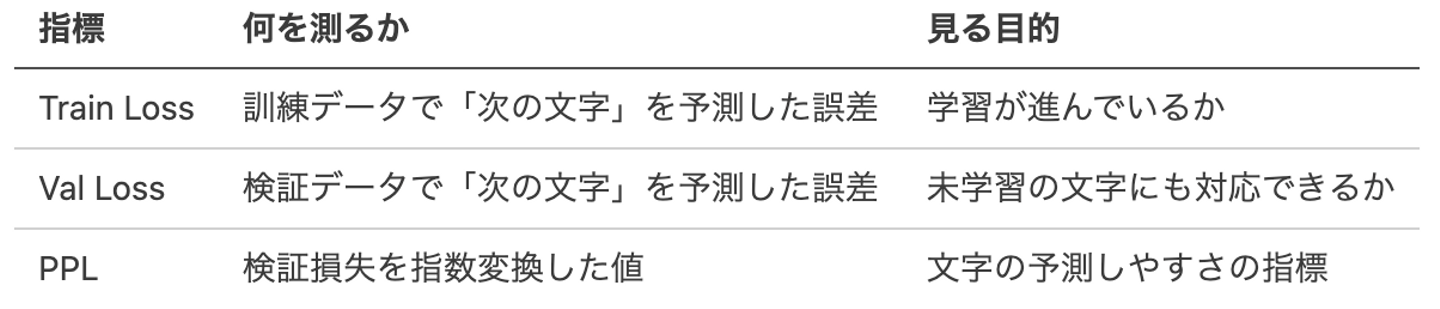
各実験の1・10・24・40エポックと、検証損失が最小だった時点の値をまとめました。
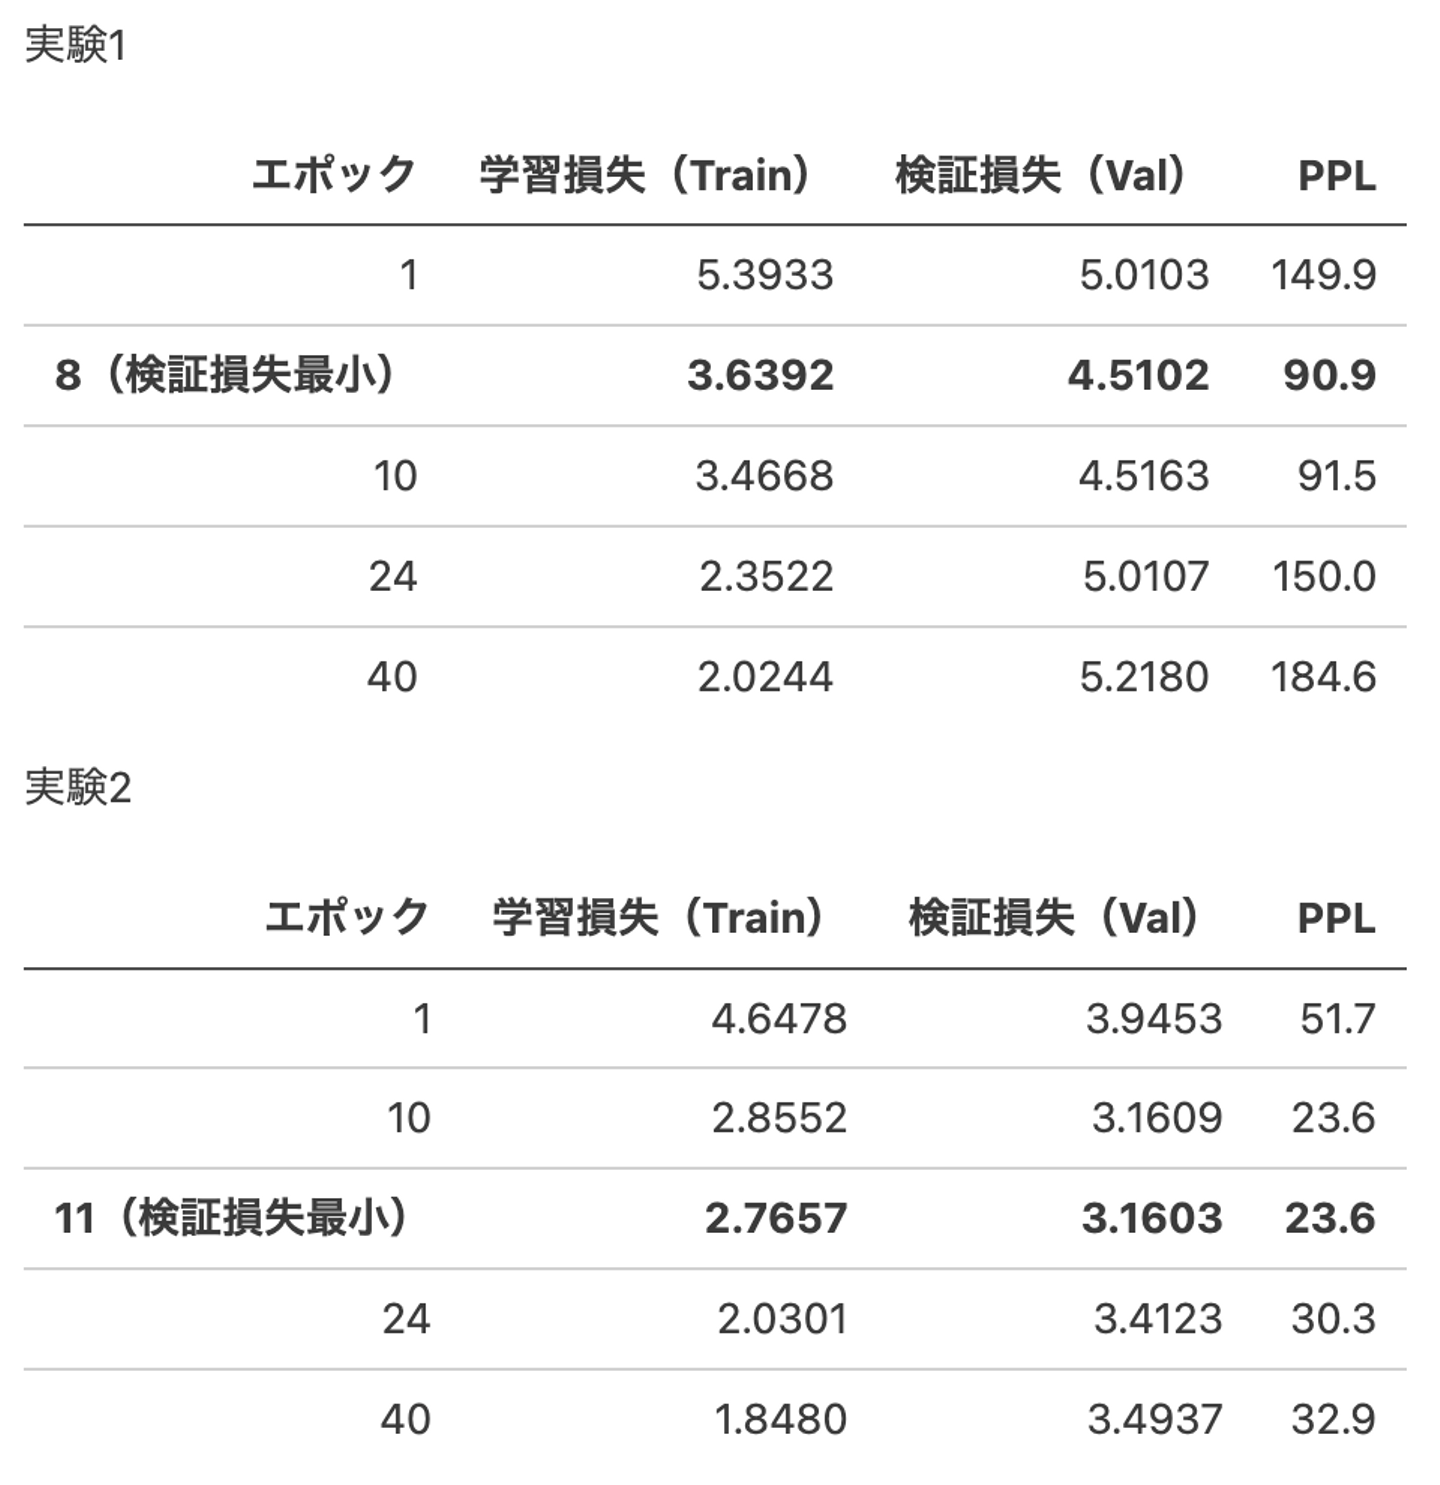
※検証損失が最小だった実験1の8エポック、実験2の11エポックでは生成文を記録していないため、最良時点に近い生成例として10エポックの出力を掲載しています。
学習損失、検証損失の推移グラフも掲載しておきます。
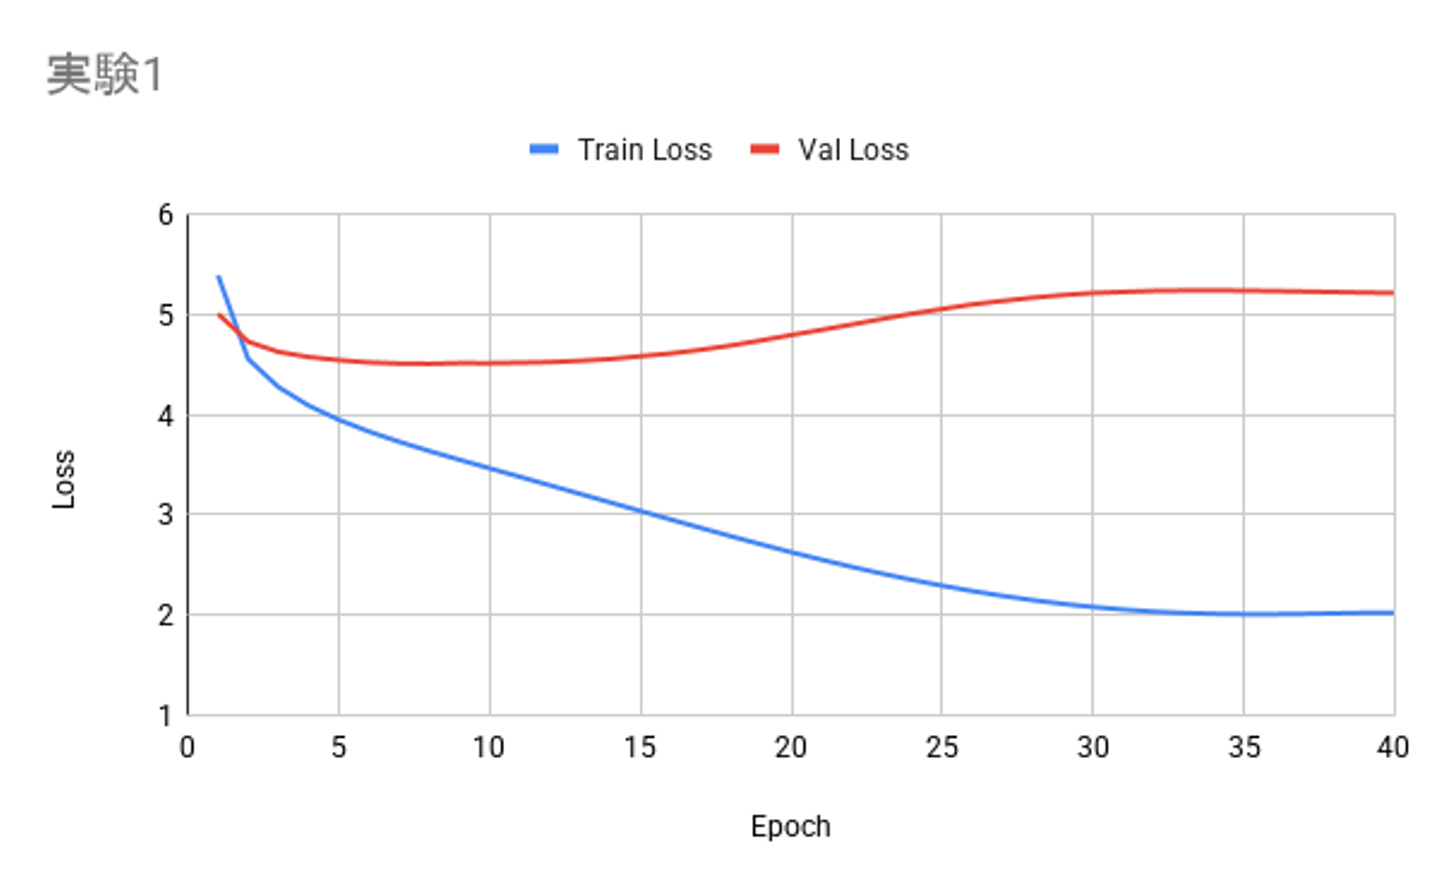
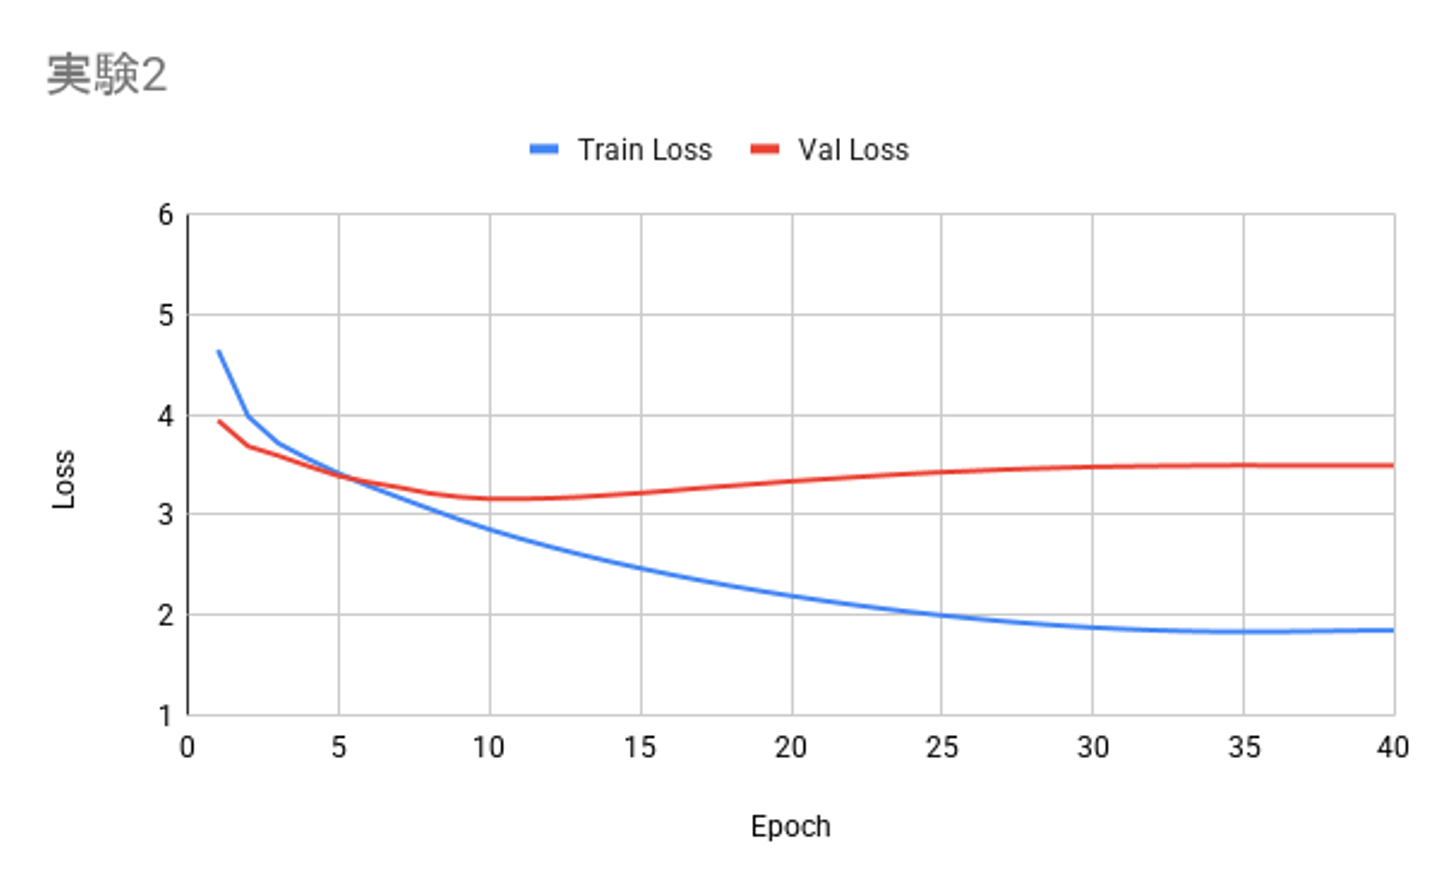
両実験とも、検証損失が最小となった後も学習損失はさらに下がりましたが、検証損失は上昇しました。学習用テキストへの適応が進む一方で、検証用テキストでの予測が悪化する、過学習の傾向が見られました。
学習を進めていくことで学習データへの適応が進んでも、未学習の文章の予測が改善し続けるわけではないようです。
1作品と3作品の生成例を比べると、10エポック時点では、3作品で学習したモデルに「吾輩はこの言葉を眺めた。」という自然に読める一文が見られました。一方で、どちらも文章全体の意味のつながりには課題が残りました。
まとめ
今回は、夏目漱石の1作品と3作品を使ってミニLLMを学習させ、生成文の変化を観察してみました。学習によって、ただの文字の羅列から文章らしい出力へと変化することが確認できました。
一方で、学習損失が下がり続けても、検証損失は途中から上昇しました。学習を続ければ、未学習の文章の予測がよくなるわけではないこともわかりました。
学習率や学習を終了するタイミング、プロンプトに与える内容、モデルの構成を変えると、どのような違いが出るのか。こういった条件を変えて、いろいろと実験していくのも面白そうです。
記事を参考にシンプルな構成のミニLLMを、自分でも作って学習させて文章を生成するところまで試せました。実際に手を動かして出力や数値の変化を見ることで、言語モデルがどのように学習し、文章を生成するのか、その基礎を少し理解できたと思います。
参考図書
Interface 2026年7月号
https://interface.cqpub.co.jp/magazine/202607/
本書の【特設】Pythonで300行!ミニLLMを作るを参考にさせていただきました
作ってわかる大規模言語モデルの仕組み
https://bookplus.nikkei.com/atcl/catalog/26/03/09/02514/
今後モデルを発展させていく場合の参考にしたい資料です

/assets/images/3042976/original/aaca4216-89dc-4547-b697-422a9aaca2e6?1534996200)