こんにちは!ワミィの長川です。
今回はエンジニア採用における、書類選考へのAI活用をテーマにお届けします。
「応募数は増えたけれど、応募書類を1通ずつ読み込む時間が足りない」「技術スタックの記載が複雑で、一次選考の判定基準が担当者ごとにブレてしまう」
エンジニア採用の書類選考では、こうした悩みが尽きません。
生成AIを使えば、この負担は大きく減らせます。ただし、「AIに丸ごと任せる」と痛い目を見るのもこの工程の特徴です。今回は、実際に使えるプロンプトと運用フロー、そして知っておくべき精度の限界を整理します。
目次
1. 書類選考にAIを使うメリットと、やってはいけない使い方
まず、メリットと注意点を整理しておきます。
AIを使う主なメリットは3つです。長文の応募書類から要点を数秒で抽出・要約できること。担当者の熟練度や体調によって評価がブレるのを防ぎ、判定基準を標準化できること。言語・フレームワーク・クラウド環境などの技術スタックを、見落としなく網羅的にチェックできることです。
一方で、「AIに合格・不合格の最終判断を完全に任せる」のはおすすめしません。生成AIには、事実と異なる内容を生成してしまう「ハルシネーション」のリスクがあり、また文章表現の巧みさに評価が引きずられるバイアスもあります。GitHubのコードの質やポートフォリオの真偽を完璧に見抜くこともできません。
重要なのは、AIを「下読みと要約、一次的なフラグ付けを行うアシスタント」と割り切り、最終判断は人が行うことです。
2. エンジニアの書類選考でAIをそのまま使うと危険な理由
エンジニアの書類選考には、特有の落とし穴がいくつかあります。
一つ目は、技術キーワードの表面的な一致・不一致だけで判断してしまうことです。AIは「文字としてのキーワード」は拾えますが、その「文脈やスケール感」を正確に区別するのが苦手です。
- 用途の文脈が抜ける例:同じ「Python経験あり」でも、ライブラリを使った「データ分析業務」なのか、フレームワーク(Django等)を使った「Webサービスのバックエンド開発」なのかを正しく見極められない。
- スケール感の文脈が抜ける例:同じ「Rails経験あり」でも、「個人開発レベル」なのか「数百万ユーザーを抱えるプロダクション環境での運用経験」なのかを文字だけで正しく評価できない。
二つ目は、経歴の「量」と「質」を混同しやすいことです。転職回数が多い候補者を一律にネガティブ評価したり、逆に職務経歴書の書き方が上手な候補者を実力以上に高く評価したりする傾向があります。文章力と技術力は別物ですが、AIは文章から判断する性質上、この2つを分けて評価するのが苦手です。
三つ目は、成長ポテンシャルやカルチャーフィットのような、数値化しにくい要素を評価できないことです。特にポテンシャル採用や未経験からの転向者を見る場合、書類上の経験年数だけでは測れない部分を、AIは原理的に拾い上げられません。
3. 実践的な使い方
3-1. コピペで使えるプロンプトテンプレート
募集要項と職務経歴書を貼り付けるだけで使える、実践用のプロンプトです。
プロンプト例
# 目的

あなたは優秀なIT人事・エンジニア採用担当者です。

提供された「募集要項」と「求職者の職務経歴書」を照らし合わせ、

一次選考における適合度を客観的に評価・要約してください。


# 募集要項

[ここに自社の募集要項・必須要件・歓迎要件を貼り付け]


# 職務経歴書

[ここに求職者の職務経歴書のテキストを貼り付け]


# 出力フォーマット

以下のフォーマットに従って出力してください。


1. 総合評価フラグ:(S / A / B / C の4段階で出力)

   - S: 必須要件・歓迎要件を高度に満たしている

   - A: 必須要件を満たしており、面接推奨

   - B: 必須要件の一部に不安あり(要確認)

   - C: 必須要件を満たしていない

2. 判定理由(150文字程度):

3. 必須要件チェック:

   (募集要項に記載された必須要件ごとに、○ / △ / × と補足を記載)

4. 注目すべき実績・強み(箇条書き3つ):

5. 面接で深掘りすべき懸念点・確認事項(箇条書き2つ):
このフラグはあくまで参考情報です。特に「C」評価は、AIの誤判定によって本来会うべき候補者を見逃すリスクがあるため、お見送り連絡の前に必ず人の目で内容を確認してください。
3-2. PDFで受け取った職務経歴書の扱い方
職務経歴書はPDFで提出されることが多く、コピペすると文章の順番が崩れてしまうことがあります。生成AIはPDFファイルを直接アップロードして読み込めるので、コピペせずそのままファイルを渡す方が手間はかかりません。
ただし、職務経歴書には氏名や連絡先といった個人情報が含まれています。ファイルをそのままアップロードする前に、先頭部分(氏名・連絡先・写真など)を黒塗り(マスキング)してから渡すのがおすすめです。多くの職務経歴書はこうした個人情報が冒頭にまとまっているため、そこだけ隠せば経歴部分の情報はそのまま活用できます。
マスキングは、PDF編集ソフトの塗りつぶし機能や、スクリーンショットを撮って画像化してから該当箇所を隠す方法が手軽です。ただし、単に黒い四角形を重ねただけだと、下に文字データが残ったままのことがあるので注意してください。
文字選択できないスキャン画像のPDFの場合は、OCRツールで一度テキスト化してから使うとよいでしょう。
3-3. AI×人間のハイブリッド運用フロー
プロンプトを使ってチームで運用する際は、次の3ステップに分けると迷いがなくなります。
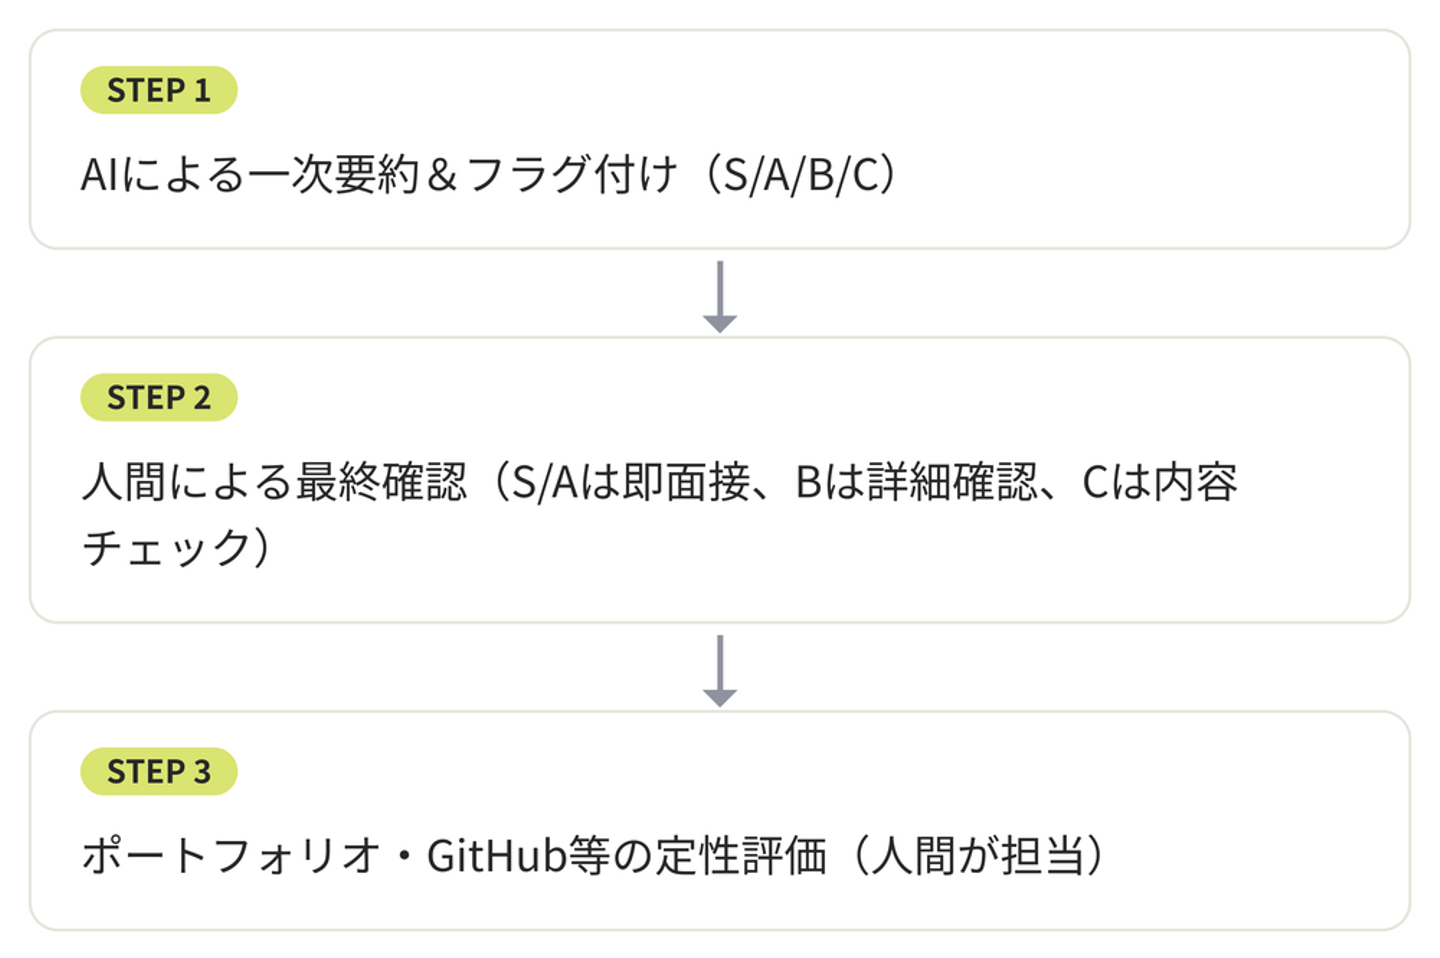
STEP 1:AIによる一次解析
応募が来たら、プロンプトを使ってAIに要約とS〜Cのフラグ付けを行わせます。これだけで、1通あたりにかける確認時間を短縮できます。
STEP 2:人間によるダブルチェック
S・A評価は、要約と懸念点だけ確認して一次面接やカジュアル面談へ案内します。B評価は、AIが挙げた「要確認ポイント」を中心に、人が職務経歴書を熟読して判断します。C評価も、必ず人が目を通し、AIの誤判定がないか確認したうえでお見送り対応とします。
STEP 3:コードやポートフォリオの定性チェック
GitHubのリポジトリや技術ブログ(Qiita・Zennなど)の実績は、エンジニアメンバーや採用担当者が実際に目を通し、チームフィットや技術への熱量を見極めます。ここは、これまでの記事でも触れてきた通り、AIには代替できない領域です。
4. 精度の限界の具体例
実際にAIを使っていると、次のような誤判定パターンによく遭遇します。
技術キーワードの過大評価です。「AWSを利用したことがある」という一文から、AWSの深い運用経験があると読み取ってしまうケース。実際には、他のメンバーが構築した環境を触った程度のこともあります。
マイナー技術の見落としもあります。候補者が使っている技術が一般的でない名称や社内独自のツール名で書かれている場合、AIがその技術の重要性を正しく評価できないことがあります。
文章量と経験の相関の誤認も起きやすい落とし穴です。職務経歴書の記述が詳細で長い候補者を「経験豊富」と判断しやすい一方、簡潔にまとめる候補者を過小評価する傾向があります。
これらはいずれも、AIが「書かれた言葉」から判断する仕組み上、避けられない限界です。人が最終確認する工程を省略しないことが、こうした誤判定を防ぐ唯一の方法です。
5. 活用する上での注意点
書類選考にAIを使う場合、候補者の個人情報を扱うことになります。利用するAIツールが入力データを学習に利用しない設定になっているか、社内のデータ取り扱いルールに沿っているかを必ず確認してください。
また、AIによる評価が特定の属性(年齢・性別・経歴パターンなど)に対して偏った判断をしていないか、定期的に人の目でチェックすることも重要です。選考基準そのものに偏りがあると、AIはその偏りをそのまま拡大して適用してしまいます。
6. まとめ
AIを書類選考に導入する目的は、単なる時短だけではありません。作業的なスクリーニングにかける時間を減らすことで、浮いた時間を候補者一人ひとりと向き合う時間(面談・面接や惹きつけ)に充てることができます。
AIは書類選考における「情報整理」と「一次的なフラグ付け」の負担を大きく減らしてくれますが、合否判断そのものを任せるには向いていません。特にエンジニア採用では、技術キーワードの表面的な一致・不一致だけでは経験の深さを測れないため、AIの出力はあくまで「読む前の下ごしらえ」として位置づけることが重要です。
まずは直近の応募数件でプロンプトを試し、自社の判定基準に合うよう調整してみてください。チェック観点をAIに渡し、フラグに沿って人が確認し、最終判断は人が行う。この役割分担を守れば、選考スピードを上げながら、見落としや誤判定のリスクを最小限に抑えることができます。