AIに何を渡し、何を人に残すのか。その線の引き方について
9月15日に発表された、あるAIモデルの話から始めます。ただ、書きたいのは新製品の紹介ではありません。仕事のどこまでを機械に渡して、どこから先を人が持つのか。その線をどう引くか、という話です。私たちの仕事にも、まっすぐ関わってきます。
喋れない、書けない、コードも出せないモデル
2026年9月15日、TypeSafe AIという新しい研究所が、最初の公開モデル「Jev」のEarly Accessを発表しました。
このモデルは、普通のAIチャットのようにあなたと会話しません。文章も書きません。コードも生成しません。自由な文字列を生成すること自体を、目的から外しています。できるのは、判断です。
作ったのはDiogo Almeida。以前OpenAIに在籍し、言語モデルを人間の指示に従わせるための研究に携わった人物です。InstructGPTの論文ではPrimary Authorの一人に名を連ね、その後GPT-4のInstruction Followingなどにも関わっています。OpenAIを離れたあと約2年間ステルスで開発を続け、今回TypeSafe AIとJevを公開しました。
Almeidaが発表文の冒頭で投げかけている問いは、かなりシンプルです。
これほど会話能力の高いモデルが存在するのに、なぜ仕事の自動化はそれほど進んでいないのか。
実務でAIを使っている人ほど、思い当たるところがあると思います。優秀なAIが手元にある。それなのに、業務が勝手に回っているわけではない。どこかで必ず人が確認している。なぜなのか。
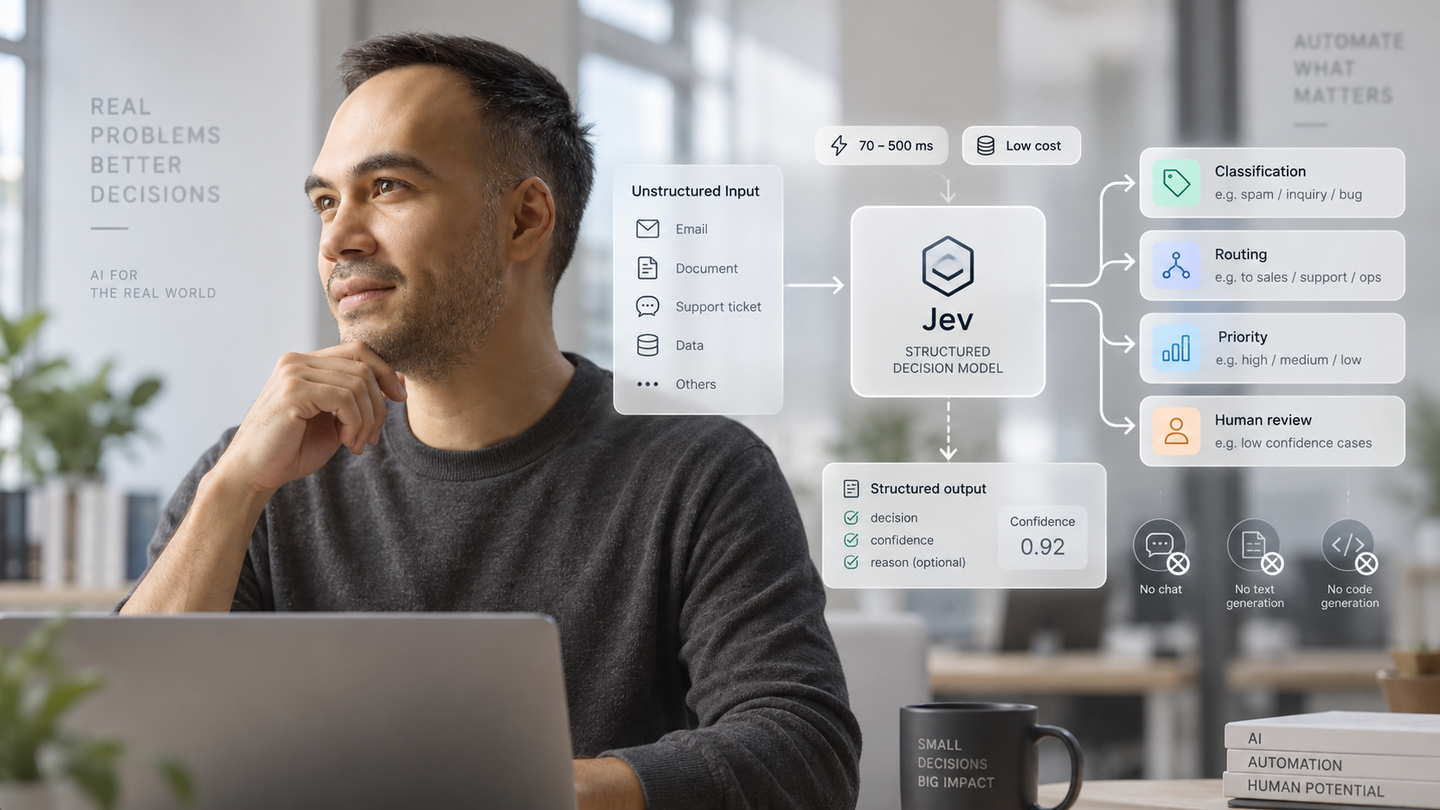
Jevの仕様はかなり極端です。応答時間は70〜500ミリ秒。入力料金は100万トークンあたり0.042ドル。そして出力料金は0ドルです。TypeSafeはJevを、いわば「高い知能を持った関数呼び出し」として位置づけています。構造化されていない情報を入れると、あらかじめ決められた型に沿って、確率を伴う判断が返ってくる。
なぜ、文字を捨てたのか
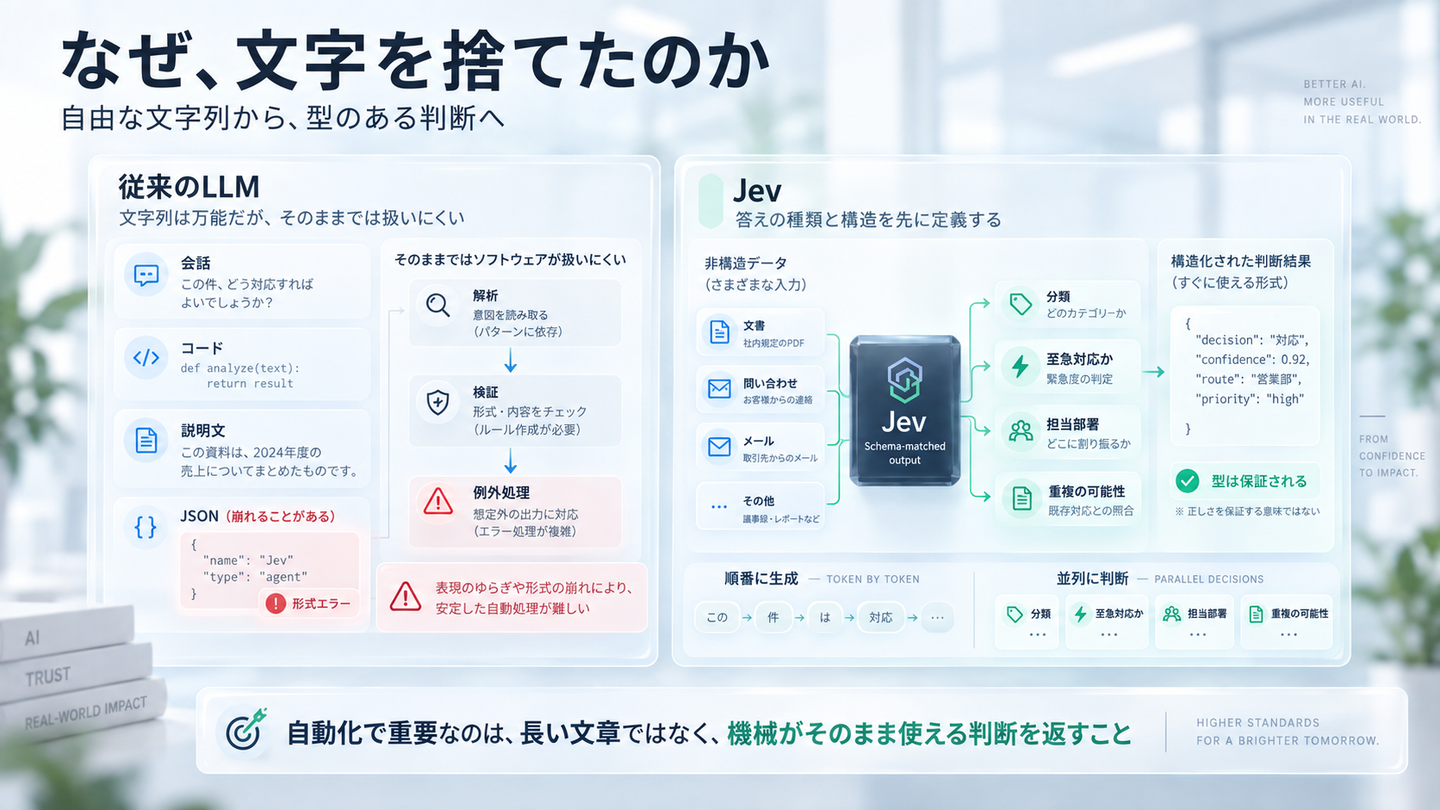
一般的なLLMが返すものは、基本的には文字列です。文字列は万能です。会話にもなる。コードにもなる。説明文にもなる。ただし、ソフトウェアがそれを直接使おうとすると、解析と検証が必要になります。
JSONで返してほしいと指示しても、モデルや使い方によっては想定外の形式が混ざる可能性がある。決めた選択肢ではない答えが返ることもある。人間相手なら大した問題ではありませんが、自動処理の途中に組み込むとなると、その一件のために例外処理が必要になります。
Jevは逆の考え方を取ります。出てくる答えの種類と構造を、先に型として定義しておく。モデルはその型に従った判断を返します。TypeSafeは、schema matchingについては保証されると説明しています。
ここは「判断が必ず正しい」という意味ではありません。型を外れた回答が返らない、という話です。実際、TypeSafeは自社資料のハルシネーション比較でJevを0%としていますが、その数字は実測値ではありません。型に一致することが保証されているため、0%としてグラフに置いていると自分たちで注釈しています。通常私たちが言う「事実を間違える」という意味でのハルシネーションとは、少し分けて考えたほうがいいと思います。
生成方法にも違いがあります。通常のLLMは、トークンを順番に生成していきます。一方Jevは、複数の判断を並列に処理することを前提に設計されています。
たとえば一つの文書について、「どの分類に当たるか」「至急対応が必要か」「担当部署はどこか」「過去案件と重複している可能性はあるか」といった複数の判断をまとめて処理する。一般的なLLMでも複数項目を一度に回答させることはできますが、Jevは最初からこの種類の独立した小さな判断を大量に処理することに特化しています。
本当の核心は、速さでも安さでもありません
この発表で、私がいちばん重要だと思ったのは速度でも価格でもありません。TypeSafeは、こんな問題を指摘しています。
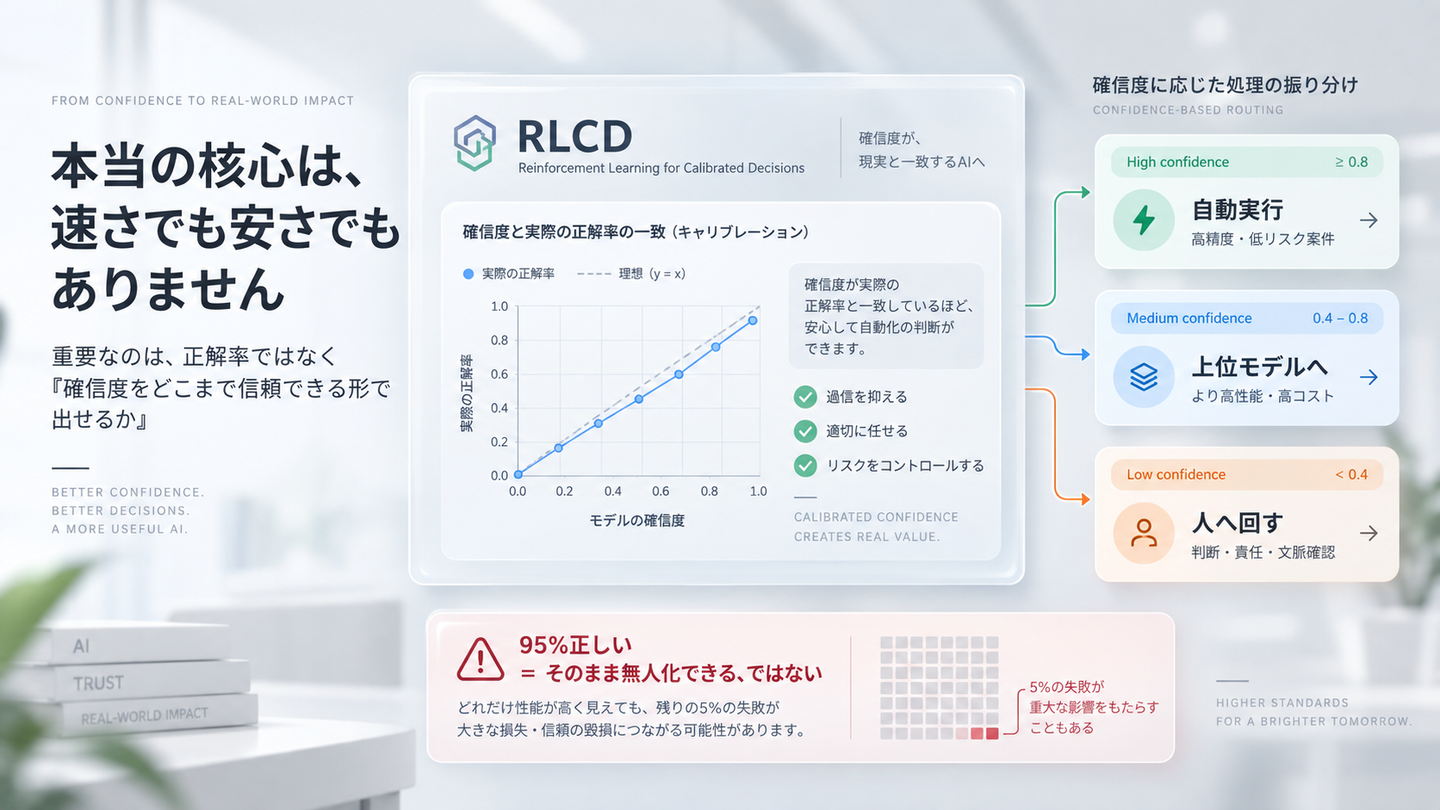
ある仕事を95%正しく処理できても、どの5%で間違えるのか自分で分からないモデルは、そのまま無人の自動処理に入れにくい。
これは現場を持っている人には、かなり分かりやすい話だと思います。95%当たるなら十分ではないか。人が使う支援ツールなら、それでも十分役に立ちます。
しかし、後ろに人がいない完全自動処理に組み込むとなると話が変わります。外れる5%がどこに紛れているのか全く判断できず、しかもミスのコストが高い仕事なら、結局かなりの件数を人が確認することになります。
重要なのは、正解率だけではありません。「自分がどれくらい確かなのか」を、どこまで信頼できる形で出せるか。
既存のLLMにも確信度を尋ねることはできます。しかし、単純に「何%自信がありますか」と聞いて返ってくる数字を、そのまま業務上の分岐条件として利用するのは危険です。
TypeSafeが新しく作った訓練手法RLCD、Reinforcement Learning for Calibrated Decisionsは、ここを狙っています。正解率だけではなく、確信度と実際の正解率を近づけることを重視する。確信度が高いときには実際にも正確で、低いときには本当に危うい。
もしそれが十分な精度で実現できれば、業務はこう設計できます。確信度が高ければ、そのまま自動実行する。中程度なら、より高性能で、より遅く高価なモデルへ回す。低ければ、人へ回す。
つまり、人が見るべき案件を、機械側で選別する。すべてを均等に人間が監督するのではなく、本当に危ないものだけを人の手元へ持ってくる。ここに、自動化という意味ではかなり大きな可能性があります。
System 1とSystem 2
TypeSafeは、この種類のモデルを「System One Model」と名付けています。由来はダニエル・カーネマンの『ファスト&スロー』です。System 1は、速く直感的な判断。System 2は、時間を使った意識的な思考です。
最近のAI、とくに推論モデルは、複雑な問題に対してより多くの計算を使い、内部で長く推論する方向へ進んできました。Jevは、その反対側に賭けています。世の中には、長い推論を必要としない小さな知的判断が大量に存在する。そう考えているわけです。
「Jev」という名前は、19世紀の経済学者ウィリアム・スタンレー・ジェヴォンズから取られています。蒸気機関の効率が上がれば、同じ仕事に必要な石炭は減ります。ところが石炭利用そのものが安く便利になることで利用範囲が広がり、社会全体ではむしろ石炭消費が増えていく。いわゆるジェヴォンズのパラドックスです。
TypeSafeは、機械の知能にも同じことが起こると考えています。知能が安くなれば、使われる知能の総量は減るのではなく、むしろ増える。かなり納得できる考え方です。
発表文が、自分自身に反論しています
ここからが、この発表をわざわざ取り上げた理由です。TypeSafeの発表文には、主要な主張の多くに「Nuance」という注釈が付いています。そしてそこには、自分たちにとって不利な条件もかなり書かれています。
たとえば、デモで使った入力は短く、情報密度の高いものを選んでいる。それによってJevが有利になっている、と明記しています。Workflow Evaluationについても、評価に使ったワークフローは自社のModel Capabilities Teamのメンバーが作っているため、何らかのバイアスが存在する可能性があるとしています。
正解の基準として他社の最上位モデルの平均を使っているため、それらのモデルに有利な評価になっている可能性も認めています。ハルシネーション率0%についても、先ほど書いた通り実測値ではありません。
そして、ホームページに大きく掲げられている「193.6倍高速」「444.6倍低コスト」という数字についても、TypeSafe自身が、現実世界で得られる改善幅としては高い側に位置するだろうと書いています。
発表資料としては、かなり面白い作りです。自分で何を載せるか決めている以上、もちろんこれは広報です。それでも私は、都合の悪い条件を自分でどこまで書けるかは、検証するときの重要な入口になると思っています。
ただし、当然限界もあります。何を注釈に書かなかったのかは、外からは分かりません。この透明性は評価材料にはなりますが、独立した第三者検証の代わりにはなりません。
私はこれを、信頼を得るための材料であると同時に、かなり洗練された製品の見せ方でもあると考えています。たぶん、両方です。
Jevにできないこと
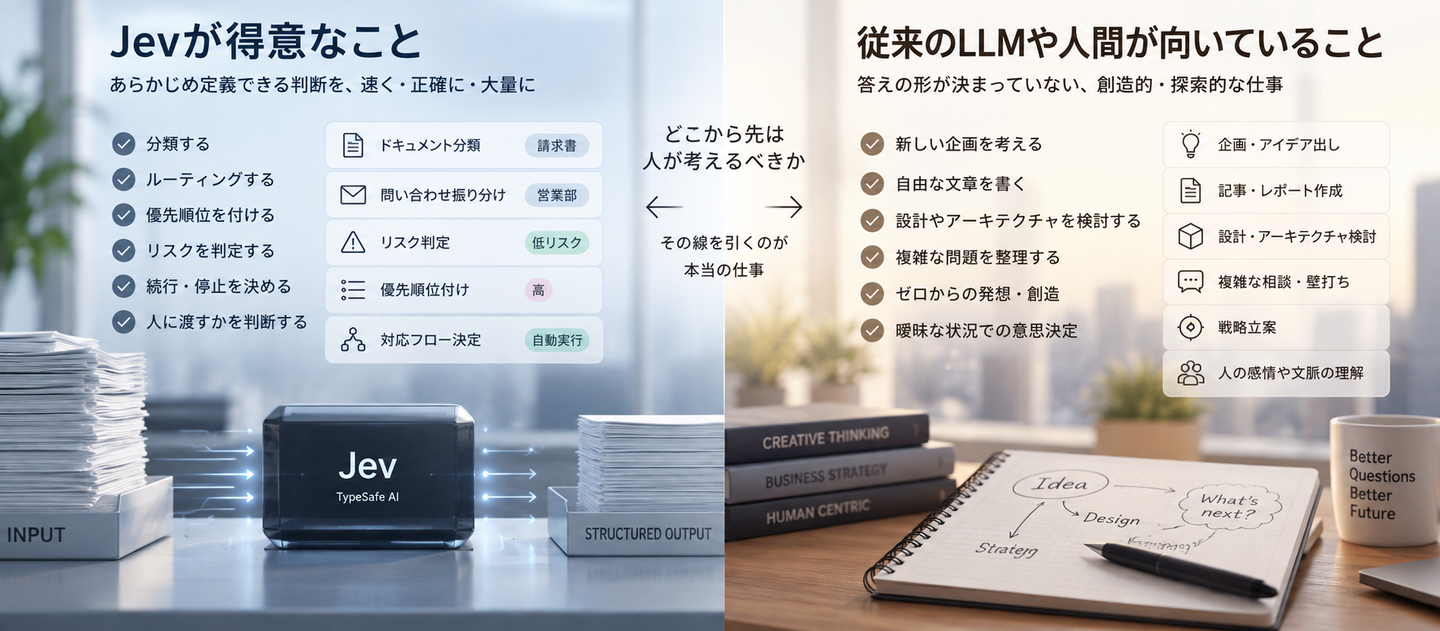
制約もはっきりしています。Jevは自由な文章を出すモデルではありません。出力の候補や尺度を、ある程度あらかじめ定義できる仕事に向いています。第一世代で、まだEarly Accessの段階でもあります。
相性がいいのは、繰り返し発生し、件数が多く、何を判断すべきかが前もって分かっている業務です。分類する。ルーティングする。優先順位を付ける。リスクを判定する。続行するか、止めるか、人に渡すかを決める。
逆に、何を作るべきか自体がまだ決まっていない仕事や、自由な文章・設計・発想が必要な仕事では、従来のLLMや人間のほうが向いています。
だから私は、「答えの形が決まっていれば機械、決まっていなければ人」と完全に二分できるとは思いません。ただ、答えの形をどこまで先に定義できるかが、自動化しやすさを大きく左右するのは間違いないと思います。
線を引くのは、誰の仕事か
この設計でいちばん難しいのは、技術ではないと思っています。線をどこに引くかです。
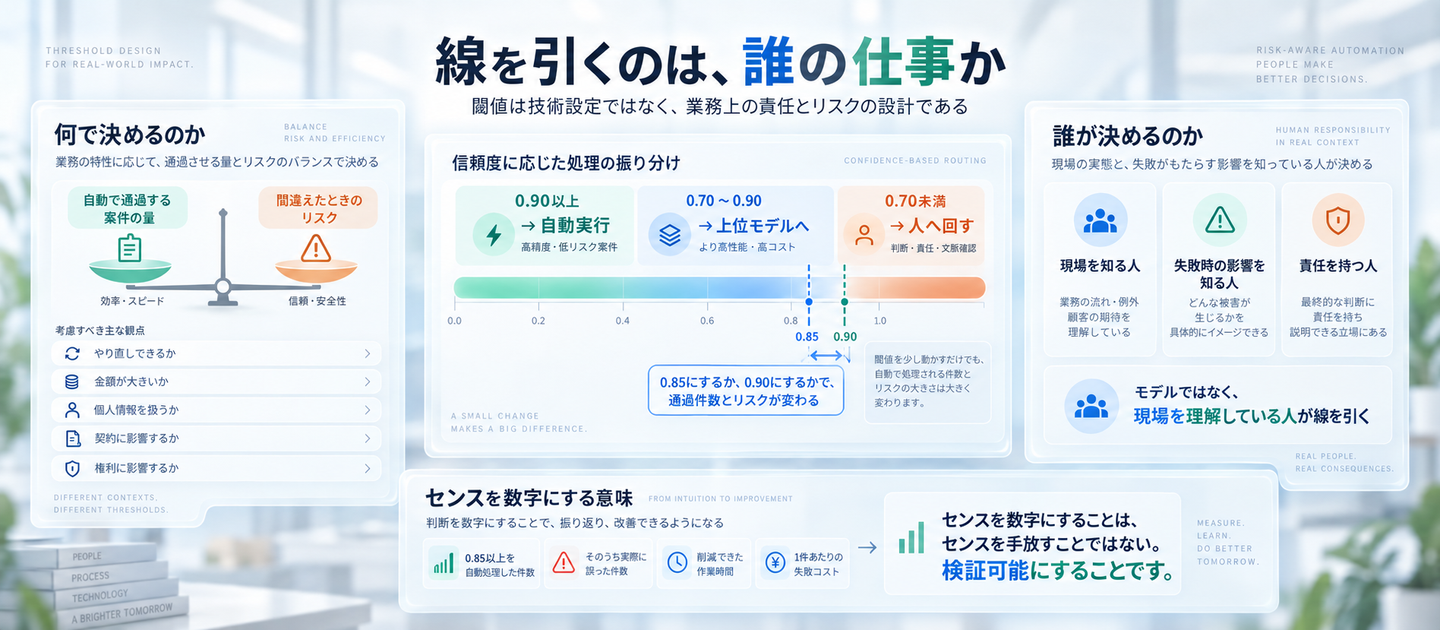
たとえば仮に、確信度0.90以上なら自動実行する。0.70〜0.90なら、より高性能なモデルに回す。0.70未満なら、人に回す。と決めたとします。
では、この0.90と0.70を誰が決めるのか。
一見すると、AIエンジニアが設定する技術的なパラメータに見えます。私はそうは思いません。0.90にするか、0.85にするか。そこで変わるのは、自動で通過する案件の量と、間違ったときに引き受けるリスクです。
この二つを天秤にかけるのは、モデルの仕事ではありません。案件ごとに違って当然です。間違えても簡単にやり直せる判断なら、線を多少低くしてもいい。一度実行したら戻せない判断なら、線は高くしたほうがいい。
金額が大きい。個人情報を扱う。契約に影響する。誰かの権利に影響する。そういう仕事なら、さらに慎重になります。その違いを決められるのは、その仕事で失敗したときに何が起きるのかを知っている人です。
モデルは、自分の判断が外れたときに、現場で何が壊れるのかまでは知りません。
私は普段から、AI時代に最後まで人に残るものの一つは「センス」だと考えています。AIとAIが同じ答えを出してきたとしても、最後の判断は自分で下したほうがいい。「二つとも同じことを言っているから正しい」という理由だけで通してしまえば、判断したのは自分ではなくなるからです。
今回の話では、その「センス」が少し具体的になります。センスを、一つの数字として先に置いておく。
そして数字にしておくと、もう一つ大きな意味があります。あとから検証できます。
0.85以上を自動処理した案件が何件あったのか。そのうち、実際には何件間違っていたのか。自動化によって何時間減ったのか。一件の失敗に、どれくらいのコストが掛かったのか。
そこまで記録できれば、次に閾値を変えられます。頭の中だけにセンスを置いたままでは、振り返ることも、共有することも、引き継ぐこともできません。
センスを数字にすることは、センスを手放すことではない。センスを検証可能にすることです。
私はそう考えています。
私たちの仕事にとって、何が変わるか
こうした道具が広がったとき、エンジニアの仕事から何かが減るのか。私は単純に「減る」とは考えていません。仕事をする位置が変わるのだと思います。
これまでAIを業務へ組み込むとき、大きなテーマの一つはプロンプトでした。どう指示すれば、期待した結果が返るのか。返ってきた文字列をどう解析するのか。想定外の返答が来たらどう処理するのか。そこを工夫してきました。
判断を返すモデルを前提にすると、考える場所が少し変わります。業務を、独立した小さな判断へ分解すること。それぞれの判断には、どんな選択肢があるのか。何%以上なら自動実行していいのか。どこから上位モデルに回すのか。どこで人を呼ぶのか。間違えたときに、どこまで戻せるのか。こうしたことを設計する必要があります。
これは、プロンプトの工夫というより業務設計です。そして業務設計には、その仕事を本当に理解していることが必要です。何が起きると困るのか。何なら間違えても修正できるのか。誰が最終的に責任を持つのか。どの時点で止めるべきなのか。
AIモデルそのものに詳しいだけでは、決められません。
だから私は、業務を理解している人が、これからもっと強くなると考えています。
客先の現場で長く働き、その業務の中身を知っているエンジニア。どの処理が重要なのかを知っている人。どこで事故が起こるのかを知っている人。そういう知識は、AIによって価値がなくなるのではなく、AIを実際の業務へ組み込むための設計材料になります。
もちろん、これはJevという第一世代のモデルを見て考えている話です。Jev自体が今後どこまで広がるのかは、まだ分かりません。
ただ、一つだけ、モデルが何世代進んでも残ると思っていることがあります。
機械にどこまで任せるか。その線を引くのは、人の仕事です。
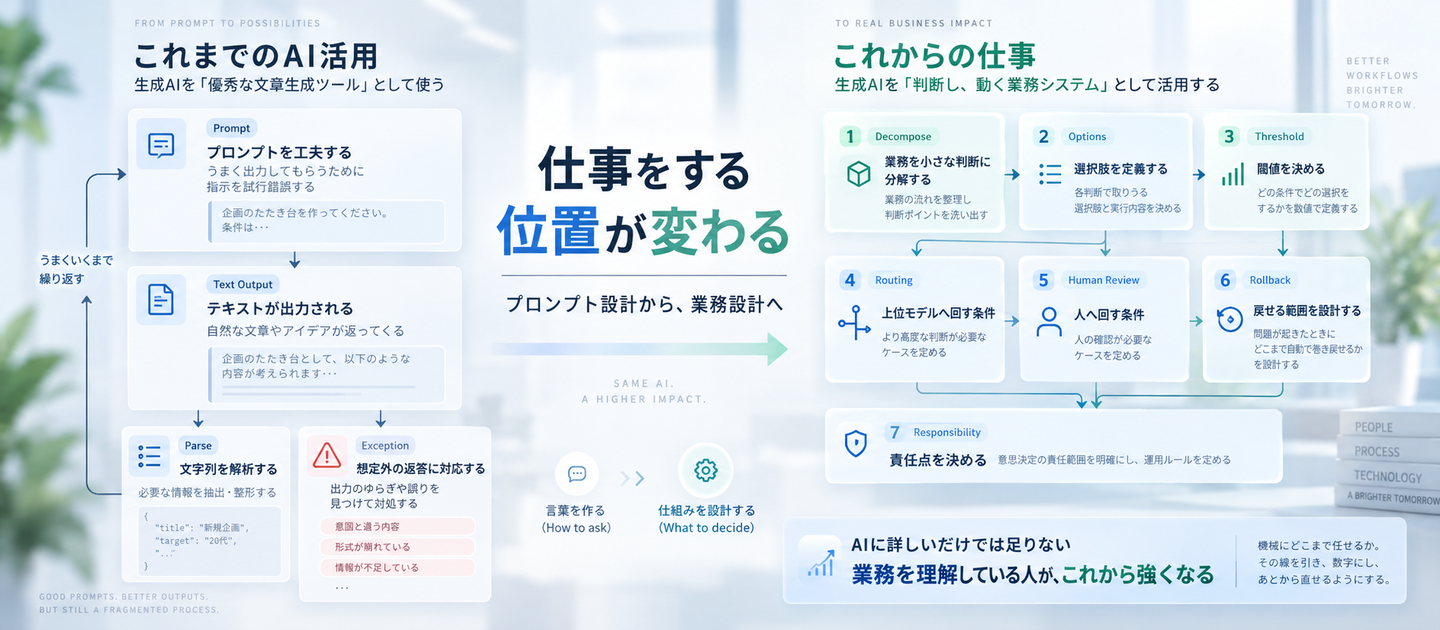
そしてこれからは、その線を感覚だけで引くのではなく、数字にし、測り、あとから直せるようにする。そこまで含めて、人の仕事になっていくのだと思います。
参考資料
- Diogo Almeida「Introducing System One Models & Jev」TypeSafe AI(2026年9月)
- TypeSafe AI「Workflow evals」
- Thomas Claburn「TypeSafe AI debuts model for machines that plays Doom」The Register(2026年9月16日)
- OpenAI「GPT-4 contributions」
- Long Ouyangほか「Training language models to follow instructions with human feedback」OpenAI(2022年)

/assets/images/22529776/original/3ae0a8df-4fcf-44fb-be80-5f71ff77ec2f?1763704732)