ChatGPTとClaudeの3つの仕事モードを整理してみた
最近、ChatGPTとClaudeを両方使っていると、面白いことに気づく。両社とも、AIの使い方をほぼ同じ「3階層」に整理し始めている。
ChatGPT:Chat / Work / Codex
Claude:Chat / Cowork / Claude Code
ちなみにClaude側は「Work」ではなく、正式名称はCoworkだ。
一見すると、どれも似ている。文章を書けるし、調査もできる。ファイルも読めるし、コードも書ける。それなら、なぜわざわざChat、Work、Codeを分ける必要があるのか。
いろいろ調べてみると、違いは「何ができるか」ではなく、AIにどこまで仕事を任せるかにあることが分かった。
最初に結論を書いてしまうと、こうなる。
Chat:相談する
Work / Cowork:仕事を任せる
Codex / Claude Code:開発環境そのものを任せる
この3つを区別すると、今のAI製品がかなり理解しやすくなる。
1.Chat:AIはまだ「対話相手」
Chatは、これまで私たちが使ってきた最も一般的なAIの形だ。
たとえば、「この契約書にはどんなリスクがありますか?」「A案とB案を比較してください」「この会社について最新情報を調べてください」「この文章の構成を改善してください」「このPythonコードはなぜエラーになるの?」と質問する。
AIは質問を理解し、必要であれば検索やファイル分析を行い、回答を返してくる。つまりChatにおけるAIは、AI Consultant、あるいはAI Copilotに近い。
重要なのは、人間が会話のループの中に残っていることだ。AIが答え、人間が判断する。方向が違えば修正し、AIが3つの案を出せば、人間が1つを選ぶ。
OpenAIもChatを、質問への回答、検索、ブレインストーミング、対話型支援などに向いた環境として位置付けている。
だから、「日本のこの労働契約条項に法的な問題はあるか」「この2つのビジネスモデルの違いは?」「記事タイトルをもう少し良くしたい」「RAGとFine-tuningの違いを説明して」といった仕事なら、基本的にChatで十分だ。無理にWorkを起動する必要はない。
2.Work:「答えて」ではなく「完成させて」
ChatGPT Workになると、AIとの関係が少し変わる。
OpenAIはWorkを、長時間かつ複数ステップにまたがる業務を処理するためのAgentとして位置付けている。調査し、情報を整理し、ファイルを扱い、ツールを操作し、最終的にWord文書、Excel、PowerPoint、レポート、Webサイトなどの完成物を作る。
ここがChatとの大きな違いだ。
たとえばChatで、
日本の生成AI企業研修市場について調査して、主要企業を教えてください。
と聞けば、欲しいのは「回答」だ。
一方、Workで、
日本の生成AI企業研修市場を調査し、主要競合を洗い出してください。価格、研修内容、対象顧客、ビジネスモデルを比較してExcelに整理し、その結果を基に経営会議向け15ページのPowerPointを作成してください。
と頼んだ場合、欲しいものは回答ではない。成果物だ。
Workはタスクを分解し、Webを調べ、情報を整理し、必要なファイルを作成する。Cloud Browserを使えば、Webサイトを開き、クリックし、入力するといったブラウザ操作も行える。Desktop環境では、権限を与えればローカルファイルやアプリを扱うこともできる。
だからWorkは、AI Knowledge Workerと考えると分かりやすい。もっと日本語らしく言えば、仕事を丸ごと渡せるAI社員に近い。
3.Workがあるのに、なぜCodexが必要なのか
ここは少し分かりにくい。Workでもコードは書けるし、GPT-5.6 SolやGPT-6 Astraそのものにも高いコーディング能力がある。
では、なぜCodexという別の製品が必要なのか。
理由は単純で、コードを書けることと、ソフトウェア開発環境で仕事ができることは別だからだ。
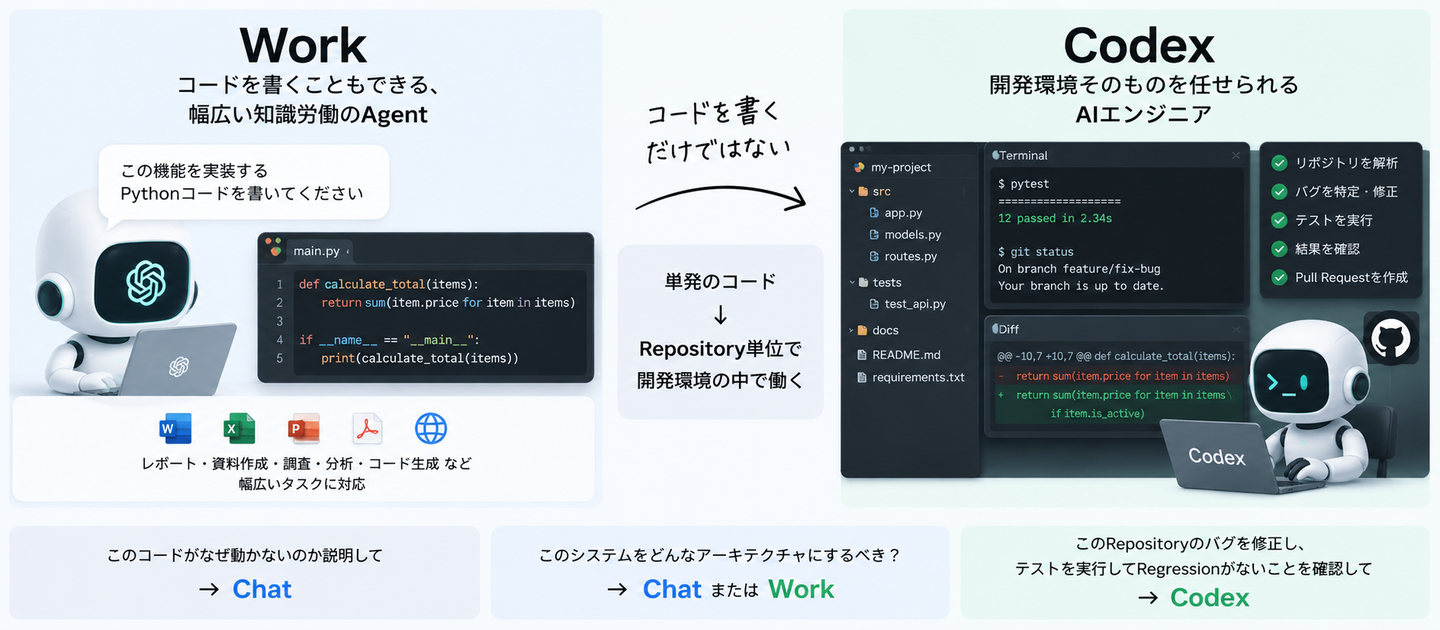
Codexが仕事の対象としているのは、単発のコードではない。基本単位はRepositoryだ。
コードベース全体を読み、ファイルを変更し、Terminalコマンドを実行する。テストを走らせ、エラーを確認し、修正し、diffを見る。Pull Requestをレビューし、必要であればさらに修正する。
つまりCodexは、単に「コードを書いてくれるチャット」ではない。ソフトウェアエンジニアとして開発環境の中で働くAgentだ。
使い分けるなら、たとえばこうなる。
「このコードがなぜ動かないのか説明して」→ Chat
「このシステムをどんなアーキテクチャにするべき?」→ ChatまたはWork
「このRepositoryのバグを探して修正し、テストを実行してRegressionがないことを確認して」→ Codex
最後の仕事をChatで延々と会話しながら進める必要はない。AIに開発環境が与えられているのだから、その中で働かせたほうがいい。
4.3つの入口では、使えるモデルも違う
2026年9月現在、ChatGPTのモデル構成はかなり複雑になっている。単純に「PlusだからGPT-5.6を使う」という世界ではなくなってきた。
通常のChatでは、Plusユーザーの中心となるモデルはGPT-5.6 Solだ。Instant、Medium、Highは基本的に同じSolで、違うのはThinking Effort、つまりどれくらい深く推論するかだ。
一方、WorkとCodexでは、Plus以上のユーザーはSol / Terra / Lunaを切り替えられる。さらにGPT-6 Astraを利用できる場合もある。
つまり、Chatでは主に「思考の深さ」を変える。一方、Work / Codexでは「使うモデルそのもの」も変える。
この違いは意外と大きい。
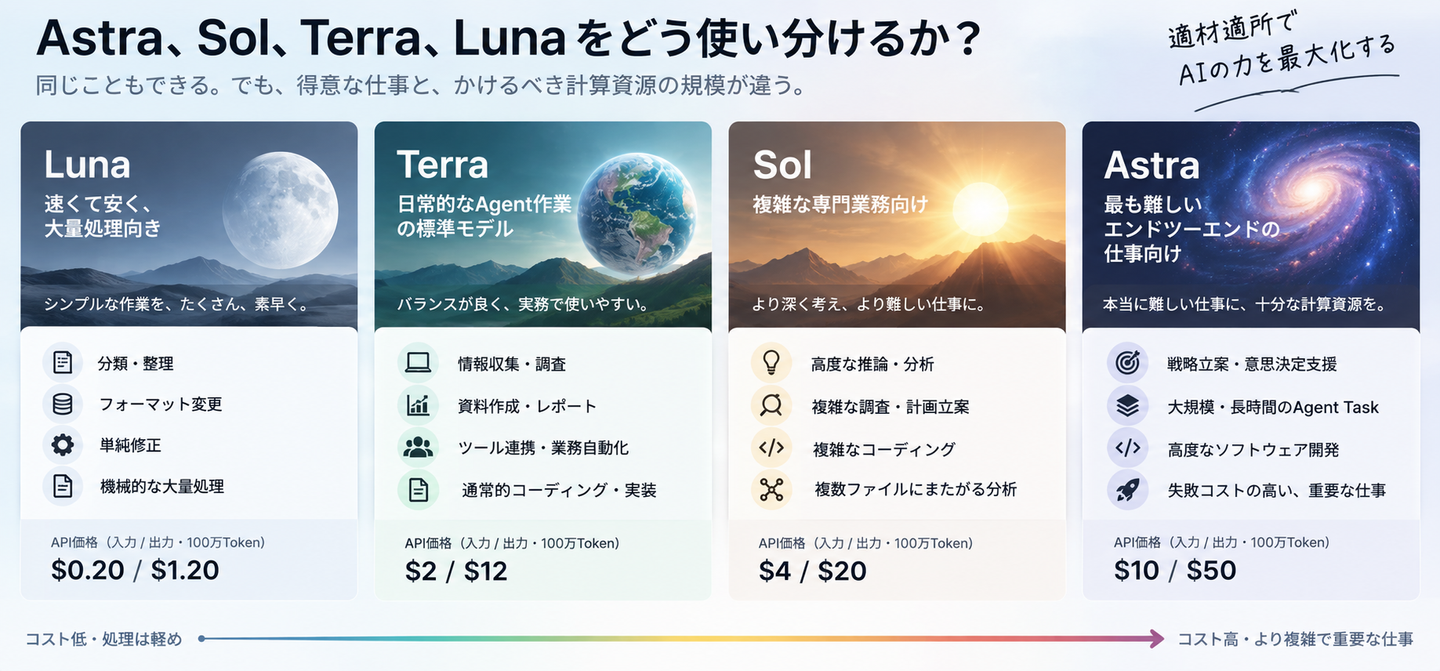
5.Astra、Sol、Terra、Lunaをどう使い分けるか
Benchmarkを全部読む必要はない。実務では、私は次のように理解している。
Lunaは、速くて安く、大量処理向き。分類、整理、フォーマット変更、単純修正、機械的な大量処理などに向いている。
Terraは、日常的なAgent作業の標準モデル。能力、速度、コストのバランスが良く、WorkやCodexで通常業務を回すなら使いやすい。
Solは、複雑な専門業務向け。高度な推論、調査、複雑なコーディング、計画立案、複数ファイルにまたがる分析などに向いている。
Astraは、最も難しいエンドツーエンドの仕事向け。「少し賢いSol」というより、この仕事には十分な計算資源を投入する価値があるという場合に使うモデルだ。
APIの標準価格を見ると、各モデルの位置付けがかなり分かりやすい。
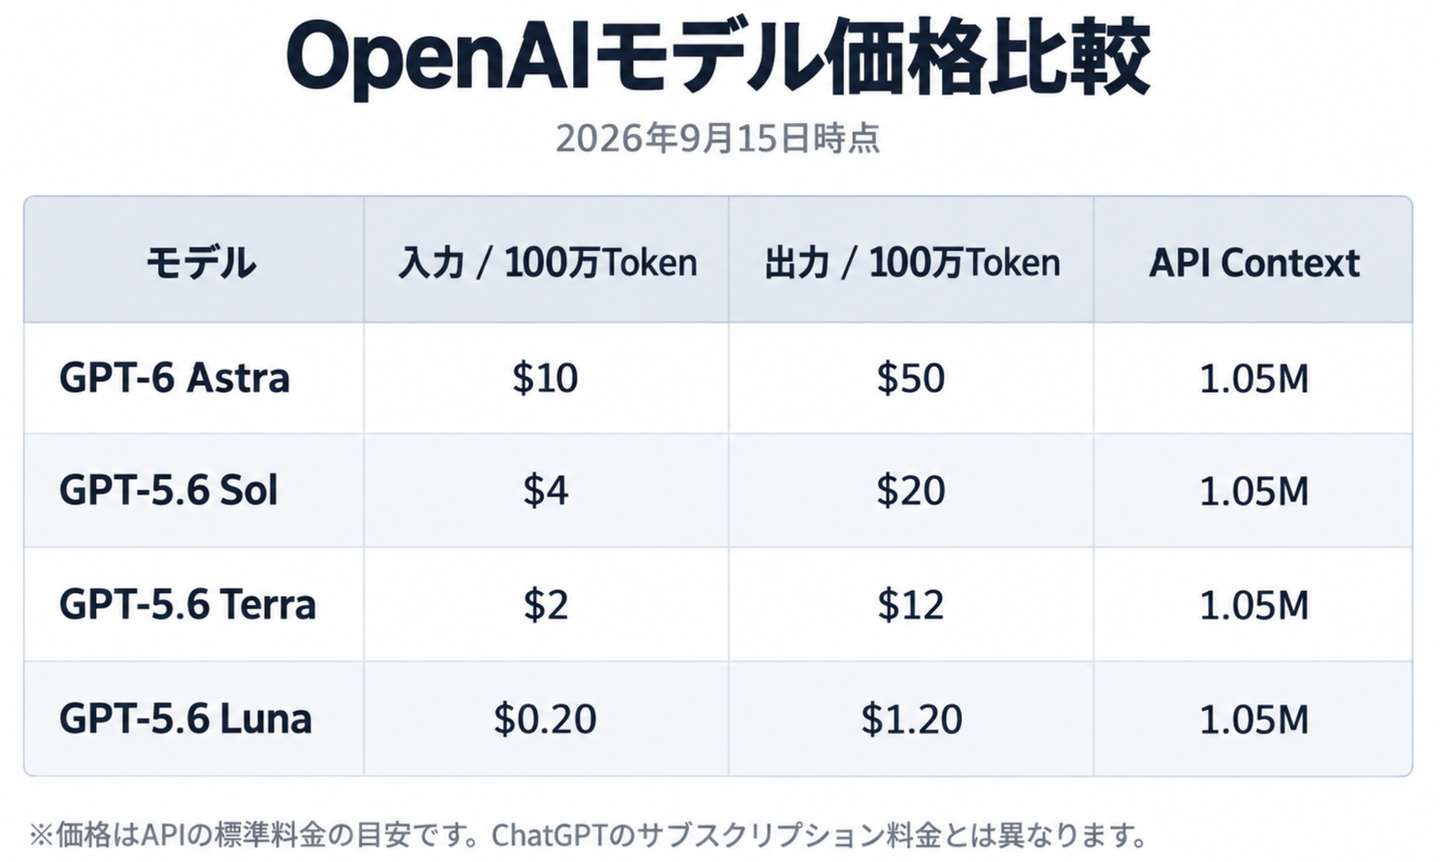
ここで注意したい。これはAPI料金だ。ChatGPT Plusで質問するたびに、この金額が追加請求されるわけではない。
ただし、各モデルの計算コストの差を理解する目安にはなる。同じ100万入力Tokenでも、SolはLunaのおよそ20倍、AstraはSolのおよそ2.5倍だ。
だからAstraを使って大量の単純ファイル整理をさせるのは、もちろん可能だ。ただ、かなり豪華な人員配置ではある。
6.では、ChatGPTの「Token消費」はどう考えるべきか
ここはかなり重要だ。
ChatGPTの通常Chat、Work / Codex、APIは、同じ「Token」という言葉を使いながら、実際にはかなり違う課金・制限体系になっている。
通常のChatでは、個人向けサブスクリプションの場合、メッセージ数やモデル利用上限として制限されることが多い。毎回「今回17,523 Token使いました」と表示されるわけではない。
一方、WorkとCodexは、よりTokenベースのAgent Usageに近い。さらにWorkとCodexは、共通のAgent Usage Poolを使用する。つまりCodexを大量に使えば、同じ期間にWorkで使えるリソースにも影響する可能性がある。
OpenAIが公開しているPlusユーザー向けの5時間あたりの目安を見ると、モデル差はかなり大きい。
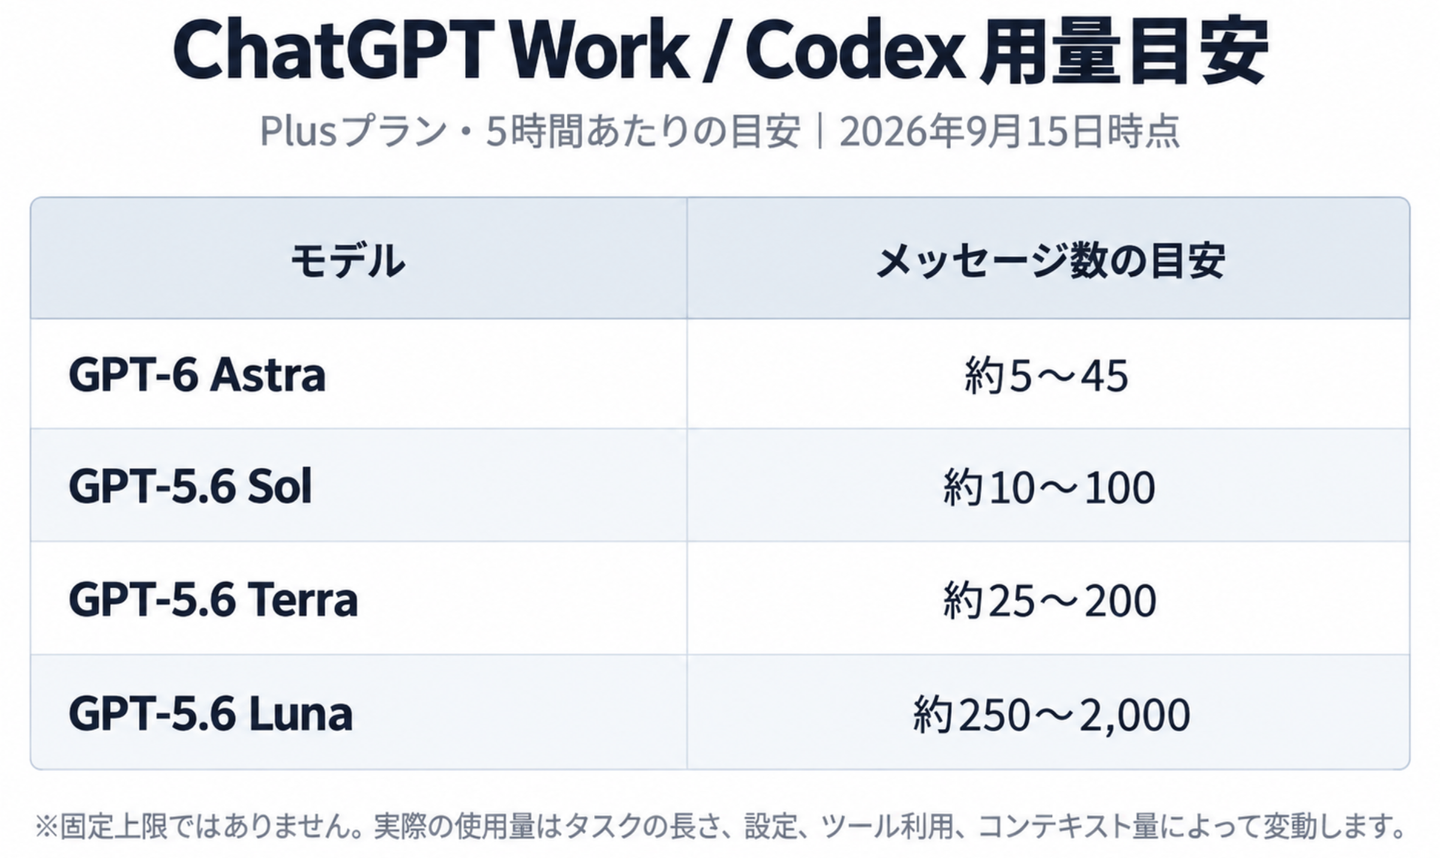
もちろん固定値ではない。同じ「1メッセージ」でも、読ませるファイル量、Conversation Context、Thinking量、ツール利用回数、Agentが何回試行錯誤するかによって大きく変わる。
ただ、この数字を見るだけでも重要なことが分かる。
どのモデルに仕事をさせるかによって、同じ契約でも実際に処理できる仕事量が数十倍違う。
だからWorkとCodexでは、「とりあえず一番強いモデル」という使い方は必ずしも合理的ではない。
7.私ならChatGPTをこう使い分ける
かなり単純化すると、こうなる。
答えが欲しい → Chat
ゴールは決まっているが、自分で作業したくない → Work
ゴールがコードベースの中にある → Codex
そのうえでモデルを選ぶ。大量の単純作業ならLuna、通常のAgent作業ならTerra、重要な調査・分析・複雑な実装ならSol。本当に難しく、価値が高く、失敗コストも大きい仕事ならAstra。
特にAgent型の作業では、最初の「考える部分」だけでなく、ファイルを読む、ツールを動かす、修正する、もう一度確認する、失敗してやり直す、といった後半部分でも大量のTokenを使う。
だから、強いモデルに方針を考えさせ、安いモデルに実行させるという方法は非常に合理的だと思う。
8.Claudeもほぼ同じ3階層になった
ここでClaudeを見てみる。
現在のClaudeも、Claude Chat / Claude Cowork / Claude Codeという3階層になっている。
Claude Chatはそのまま対話型AIだ。Coworkは、Anthropicが知識労働向けに設計したAgentで、Anthropic自身も、Claude CodeのAgentアーキテクチャをCoding以外の知識労働に拡張したものと説明している。
ファイルを読み、書き換え、ブラウザを操作し、複雑なタスクを分解し、複数ステップを実行して最終成果物を作る。つまりChatGPT Workとかなり近い。
Claude Codeは、その名前通りソフトウェア開発向けだ。
そのため、OpenAIとAnthropicの製品は現在、かなりきれいに対応している。
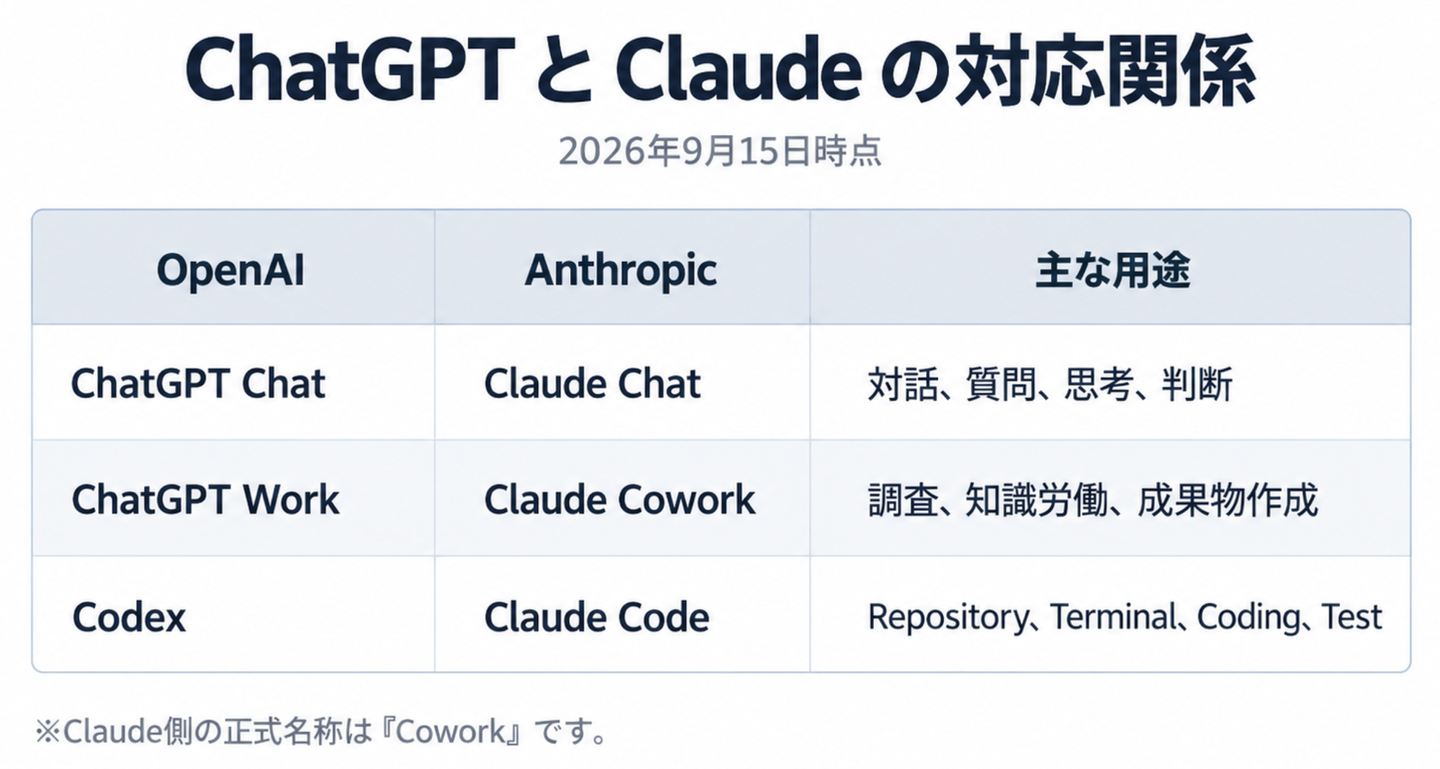
別々に進化してきた2社が、最終的にかなり似た形にたどり着いた。おそらく偶然ではない。
モデルが強くなればなるほど、Chatbotという箱だけでは能力を持て余すからだ。
9.Claudeのモデルはどうなっているのか
2026年9月時点で、Claudeでは主に次のモデル階層を意識しておけばいい。
Claude Fable 5.1 / Claude Opus 5 / Claude Sonnet 5 / Claude Haiku 4.5
大まかに整理すると、Fable 5.1は最も難しい推論や長時間Agent Task向け。Opus 5は複雑なAgent Codingや高度な知識労働向け。Sonnet 5は速度、能力、コストのバランス型で、日常利用の中心。Haiku 4.5は高速・低コストで、単純処理や大量実行向けだ。
API価格は次のようになっている。
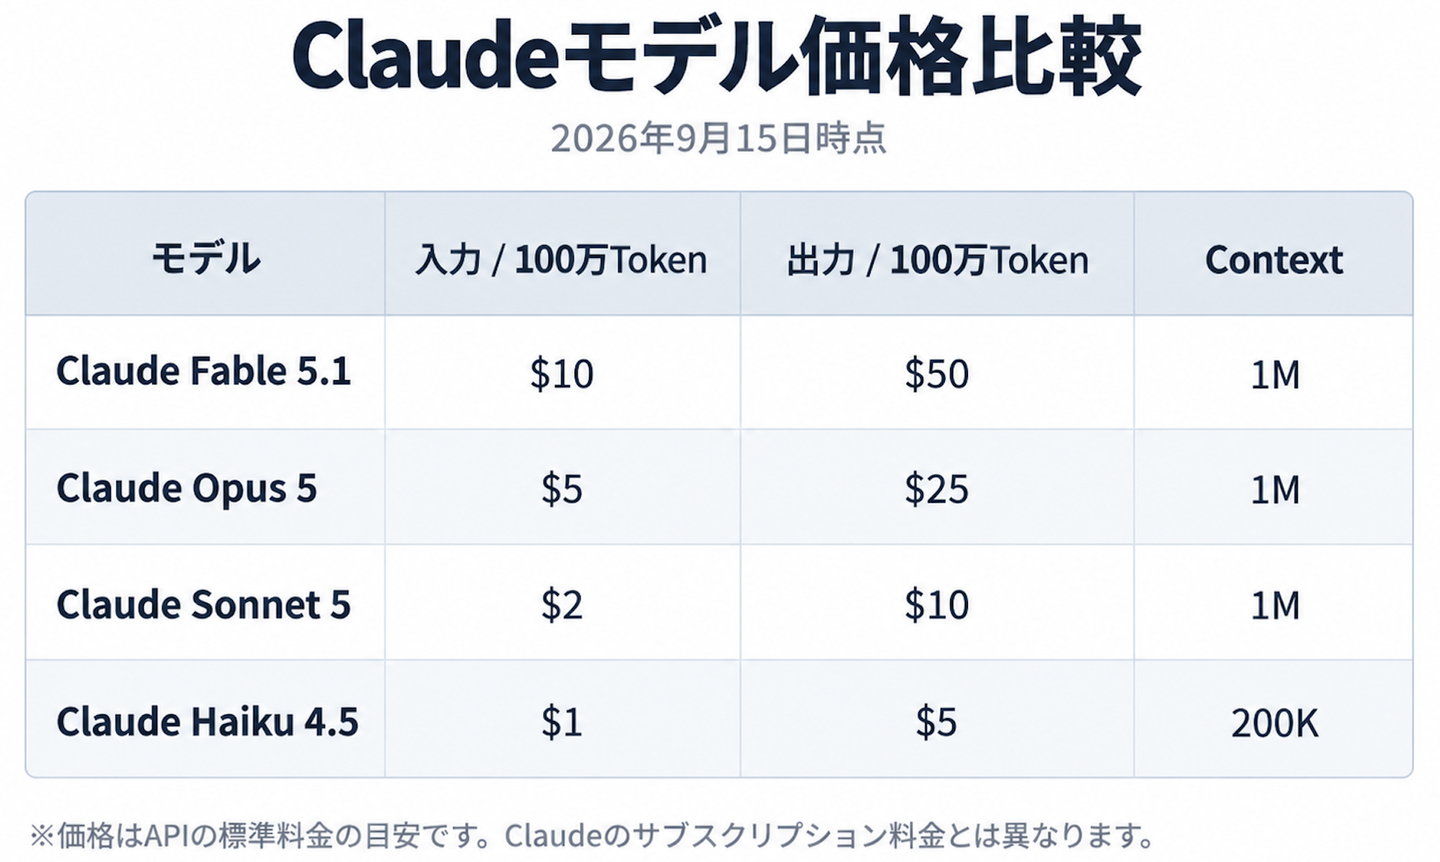
考え方としてはOpenAIにかなり似ている。難しい仕事にはFable、高度な専門業務ならOpus、通常業務ならSonnet、大量・単純作業ならHaiku。
Claude Code側でも、難しい設計やPlanをOpusに任せ、実装をSonnetで進めるといった使い分けが推奨されている。これもAgent時代には非常に重要な考え方だ。
10.ClaudeとChatGPTではUsageの考え方が少し違う
両社の違いとして面白いのが、利用上限の考え方だ。
ChatGPTでは、通常ChatとWork / CodexのUsageが比較的分けられている。一方Claudeでは、Claude.ai、Desktop、Claude Codeなど複数の入口の利用が、全体のUsage Limitに影響する。
個人向けでは、Pro:$20 / 月、Max 5x:$100 / 月、Max 20x:$200 / 月などのプランがある。5xや20xは、Proに比べたSession Usageの大きさを示している。
Claudeでは5時間単位のSession Limitに加えて、Weekly Limitも存在する。そのためClaudeでは特に、Conversationを必要以上に長くしないことが重要になる。
11.Claude Codeでは「長い会話」そのものがコストになる
Claude Codeの仕組みを理解すると、Tokenがなぜ減っていくのかがよく分かる。
Claude Codeでは次の質問をするときに、これまでのConversation、すでに読み込んだプロジェクト情報、読み込んだファイル、今回のPromptなどがContextとして送られる。
つまりSessionが長くなるほど、毎回抱えて運ぶ荷物が増えていく。
10ターン目より100ターン目のほうが、同じ「修正してください」という質問でも重くなる可能性が高い。
そのためClaude Codeには/clearや/compactといった機能があり、タスクが変わったらConversationを整理することが推奨されている。
これはAIが混乱しないためだけではない。Tokenを節約するためでもある。
12.「100万Token」の価格だけを比べてはいけない
もう一つ注意したいことがある。
OpenAIの100万TokenとClaudeの100万Tokenを、完全に同じ情報量として単純比較することはできない。Tokenizerが違うからだ。
Anthropicは、Claude 4.7以降で新しいTokenizerを採用しており、同じテキストでも以前よりToken数が増えるケースがあると説明している。
つまり、GPT-5.6 Solが$4 / MTok、Claude Opus 5が$5 / MTokだからといって、「Claudeは25%高いだけ」とは言い切れない。
実際のコストには、Tokenizer、Prompt Caching、Reasoning Token、Tool Call、Agent Loop、やり直し回数などが影響する。
そしてもっと重要なのは、1回で仕事を終えられるかどうかだ。
安いモデルが3回失敗し、高いモデルが1回で完成させるなら、最終的には高いモデルのほうが安いこともある。
だからAgent時代に本当に比較すべきなのは、Cost per Tokenではなく、Cost per Successful Taskだと思う。
13.ChatGPTとClaude、どちらの設計が良いのか
ここまで来ると、「ChatGPTとClaudeはどちらが強いのか」という問い自体が少し古く感じる。
むしろ見るべきなのは、どんな仕事の流れを作れるかだ。
ChatGPTの面白さは、モデル階層がかなり細かく分かれていることにある。Work / CodexではLuna、Terra、Sol、Astraと段階的に使い分けられる。
特にLunaとAstraではコスト差が非常に大きいため、高性能モデルで考え、低コストモデルで大量実行するという設計がしやすい。
一方Claudeは、Chat → Cowork → Codeという製品思想が非常に分かりやすい。しかもCowork自体がClaude CodeのAgent Architectureから発展したものなので、Agentとしての設計思想にも一貫性がある。
そして両社とも結局、同じ方向へ向かっている。
AIはもう、「何でも質問できるChat画面」だけでは足りない。
14.これから重要なのは「どのモデルを使うか」だけではない
以前はAIを使うとき、「どんなPromptを書けばいいか」が最も重要だった。
少し前までは、「GPTとClaude、どっちを使うか」という比較も多かった。
しかしAgent時代になると、もう一段上の判断が必要になる。まず考えるべきなのは、これはどんな種類の仕事なのかということだ。
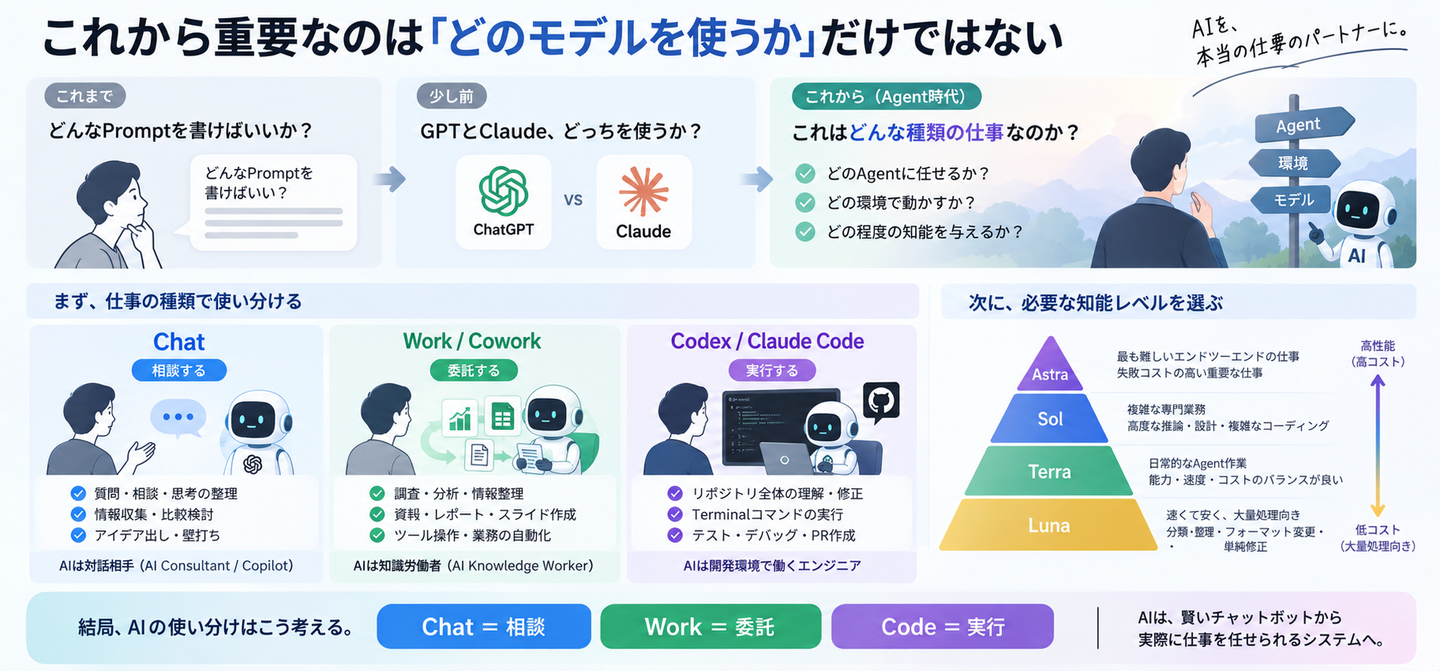
答えが欲しいならChat。成果物を作ってほしいならWork / Cowork。ソフトウェアを直接変更したいならCodex / Claude Code。
そのうえで、この仕事にはどれくらいの知能が必要かを考える。
簡単な大量処理なら低コストモデル。普通の専門業務なら中間モデル。複雑な判断や設計なら高性能モデル。本当に難しく、長時間かかり、失敗コストの高い仕事だけ最上位モデルに任せる。
私は今後、AIを使うときに重要になるのは、「どのモデルが一番賢いか」ではなく、
この仕事を、どのAgentに、どの環境で、どの程度の知能を与えて任せるか
という設計だと思っている。
そう考えると、Chat、Work、Codeは似たような3つの入口ではない。人間とAIの役割分担が一段ずつ変わっていく、まったく別の仕事モードだ。
最後に、かなり乱暴にまとめるならこうなる。
Chatは「相談」。Workは「委託」。Codeは「実行」。
この3つを意識して使い分けるようになると、AIはようやく「賢いChatbot」から、実際に仕事を任せられるシステムへ変わっていく。
※本記事の製品仕様、モデル構成、料金およびUsage情報は2026年9月15日時点の情報を基にしています。ChatGPT Work、Codex、Claude Cowork、Claude Code、および各モデルの利用上限・価格は変更頻度が高いため、具体的な利用時には各社の最新公式情報をご確認ください。

/assets/images/22529776/original/3ae0a8df-4fcf-44fb-be80-5f71ff77ec2f?1763704732)