

「画面が遅い」と言われて、そのまま DB を疑ってクエリを書き直し始めると、たいてい遠回りになる。切り分けが先である。
社内の技術共有会でこの整理をやったので、外向けに書き直して残しておく。題材はリレーショナル DB 全般で、内部の例には InnoDB を使う。
先に軸を置く。チューニングとは、ディスクへのアクセス(I/O)を減らすことである。インデックスもバッファプールもソートの除去も、打ち手は違うが戻る先は同じ一点になる。
■ 切り分け — EXPLAIN に飛びつく前に見る4つ
体感の遅さの正体は1つではない。画面の描画・再レンダリング、通信、外部 API 待ち、そして DB クエリ。どれなのかを決めないまま EXPLAIN を読み始めると、DB ではないものを DB で直そうとすることになる。
・ブラウザの開発者ツールの Network で、遅いリクエスト・API を特定する
・その処理の「どこ」が遅いかを、アプリのログ・APM・プロファイラで見る
・クエリの発行回数と実行時間を確認する。発行回数が多すぎないか、重いのはどれか
・ここで「クエリが犯人」と確定してから EXPLAIN に進む
ツールは環境に読み替えてよい。順番だけが要点である。
■ SQL は、誰が、どこでやっているのか
クライアントが SQL を送り、DB サーバーの SQL 層がパース・最適化・実行を担う。実際にデータを読み書きするのは、その下のストレージエンジンである。EXPLAIN が見せてくれるのは、真ん中の層(オプティマイザ)が決めた実行計画になる。
ストレージエンジンの中はさらに2段ある。メモリ上のバッファプールにページのコピーがあればそこで完結し、無ければディスクから読んで載せる。遅さの多くは、この「ディスクから読む」時間である。
□ 2回目が速いのは、1回目でデータがメモリに乗るから
同じクエリの2回目が速いのは、1回目でページがバッファプールに乗るからである。計測するときは、冷えた状態と温まった状態の両方を見る。
メモリとディスクの速度差について、素材にしたスライドは「数百〜数千倍(イメージ)」と書いていた。スライド自身がイメージと断っている値なので、この記事では数字を採らず「桁が違う」とだけ書いておく。
■ テーブル本体は、主キー順に並んだ実データそのもの
InnoDB のテーブルには行データを格納する特別なインデックスがあり、これをクラスタインデックスと呼ぶ。PRIMARY KEY を定義すると、InnoDB はそれをクラスタインデックスとして使う。
つまり「テーブル本体」と「主キーのインデックス」は別々のものではない。公式ドキュメントは、クラスタインデックス経由の行アクセスは索引の探索がそのまま行データのページに辿り着くため速い、と書いている。主キーでの検索がもともと速いのはこのためである。
逆に言えば、「name」 や 「age」 での検索は、これだけでは速くならない。
■ セカンダリインデックスの葉に、実データは無い
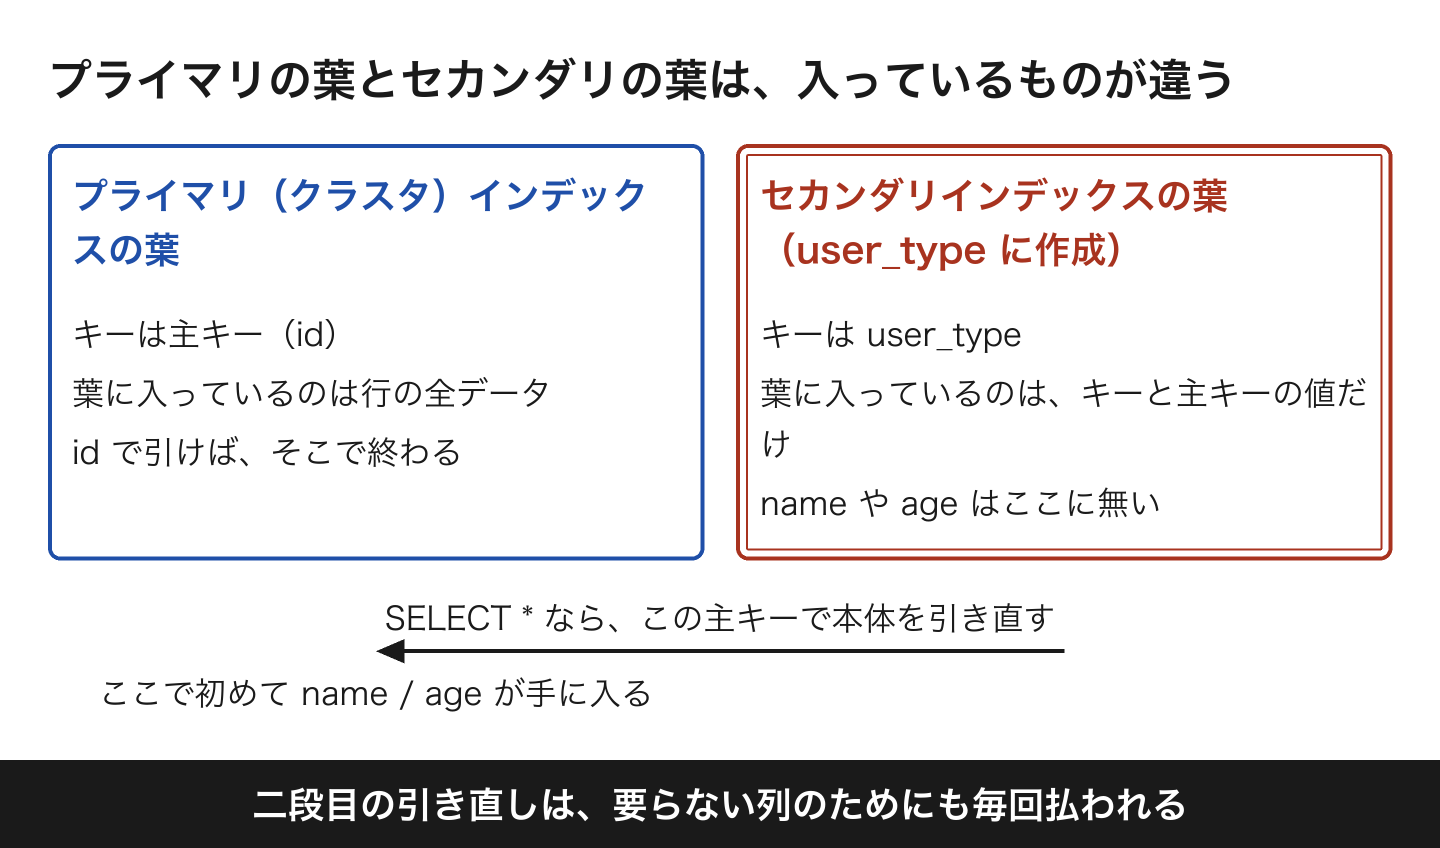
クラスタインデックス以外のインデックスをセカンダリインデックスと呼ぶ。InnoDB では、セカンダリインデックスの各レコードが持つのはそのインデックスに指定した列と、行の主キー列である。InnoDB はこの主キー値を使って、クラスタインデックスから行を探す。
□ だから SELECT * は、要らない列のために本体を引き直す
「WHERE user_type = 2」 をセカンダリインデックスで引いて手に入るのは、該当する主キーの値までである。「name」 や 「age」 が欲しければ、その主キーで本体をもう一度引く。「SELECT *」 は、この二段目を要らない列のためにも毎回払っている。
□ 必要な列が索引に揃えば、引き直しが消える
「SELECT id FROM users WHERE user_type = 2」 なら、葉に主キーが入っているので本体を見ずに終わる。「name」 も欲しいなら 「(user_type, name)」 の複合索引にする。
クエリに必要なデータが索引だけで賄えるとき、MySQL は索引の木だけを走査する。このとき EXPLAIN の Extra に 「Using index」 が出る。二段階が一段階になった合図である。
■ EXPLAIN は、まずここだけ見る
見るのは3つ。「type」(アクセス方法)、「rows」(見込み行数)、「Extra」 である。
・「type」 は公式が「最良から最悪の順」で並べている。「ALL」 は全表スキャン
・「Extra」 に 「Using filesort」 / 「Using temporary」 が出ていないか。公式も「クエリを速くしたいなら、この2つに注意しろ」と書いている
・「rows」 は見込みである。「EXPLAIN ANALYZE」 で実測と突き合わせる
見込みと実測が大きくずれていたら、オプティマイザが持つ統計が古い。統計を更新すると計画が選び直され、それだけで直ることがある。
素材のスライドには、索引を貼る前後の 「rows」 として 1,200,000 と 20 という値が載っていた。これは説明のために作られたデモ用の値で、どこかの環境の実測値ではない。before / after は自分の環境で取り直すこと。
■ ORDER BY と GROUP BY は、索引が無いとディスクに落ちる
並べ替えは、対象の行を読み込んでソート用バッファで並べ替える処理である。バッファに収まらない分はディスク上の一時領域に書かれる。これが 「Using filesort」 の正体になる。
索引はすでに並んでいるので、「ORDER BY」 の列に索引があれば並べ替えそのものが消える。順に読むだけになり、ディスクへの書き出しも要らなくなる。「ORDER BY」 / 「GROUP BY」 / 「DISTINCT」 で使う列は、複合索引の並びに含められないかを先に考える。
■ JOIN で見るのは、内部表の結合キー
MySQL は JOIN を入れ子ループで実行する。駆動表を1行ずつ取り出し、その行ごとに内部表を引く、という形である。
内部表の結合キーに索引が無ければ、駆動表の行数ぶん内部表を全表スキャンすることになる。索引があれば、1行につき木を数ホップ下るだけで済む。EXPLAIN で内側のテーブルが 「type: ALL」 になっていたら、まずそこを見る。
どちらを駆動表にするかはオプティマイザが決める。大きいテーブル同士では入れ子ループ以外の方式が選ばれることもあるので、「JOIN はいつもこう動く」と決めてかからず、EXPLAIN が何を選んだかを読む。
■ インデックスは「貼るほど良い」ではない
索引も1本ずつが B-tree である。1回の INSERT / UPDATE / DELETE で、本体だけでなくすべての索引の木を書き直す。索引が5本あれば、更新する箇所は本体と合わせて6か所になる。読みが速くなる代わりに、書きが遅くなる。使われない索引は、このコストだけを残す。
そもそも効かない場合もある。
・列を関数で包む(「WHERE DATE(created_at) = …」)
・値の種類が少なく、選択性が低い列
・件数が少なく、全表スキャンの方が速いテーブル
■ 遅いと思ったときに見る順番
・まず切り分ける。DB が本当に犯人か(開発者ツール・ログ・プロファイラ)
・EXPLAIN で確認する。「type: ALL」 や 「Using filesort」 が出ていないか
・索引を貼って、実測で再計測する。before / after を 「EXPLAIN ANALYZE」 で見る
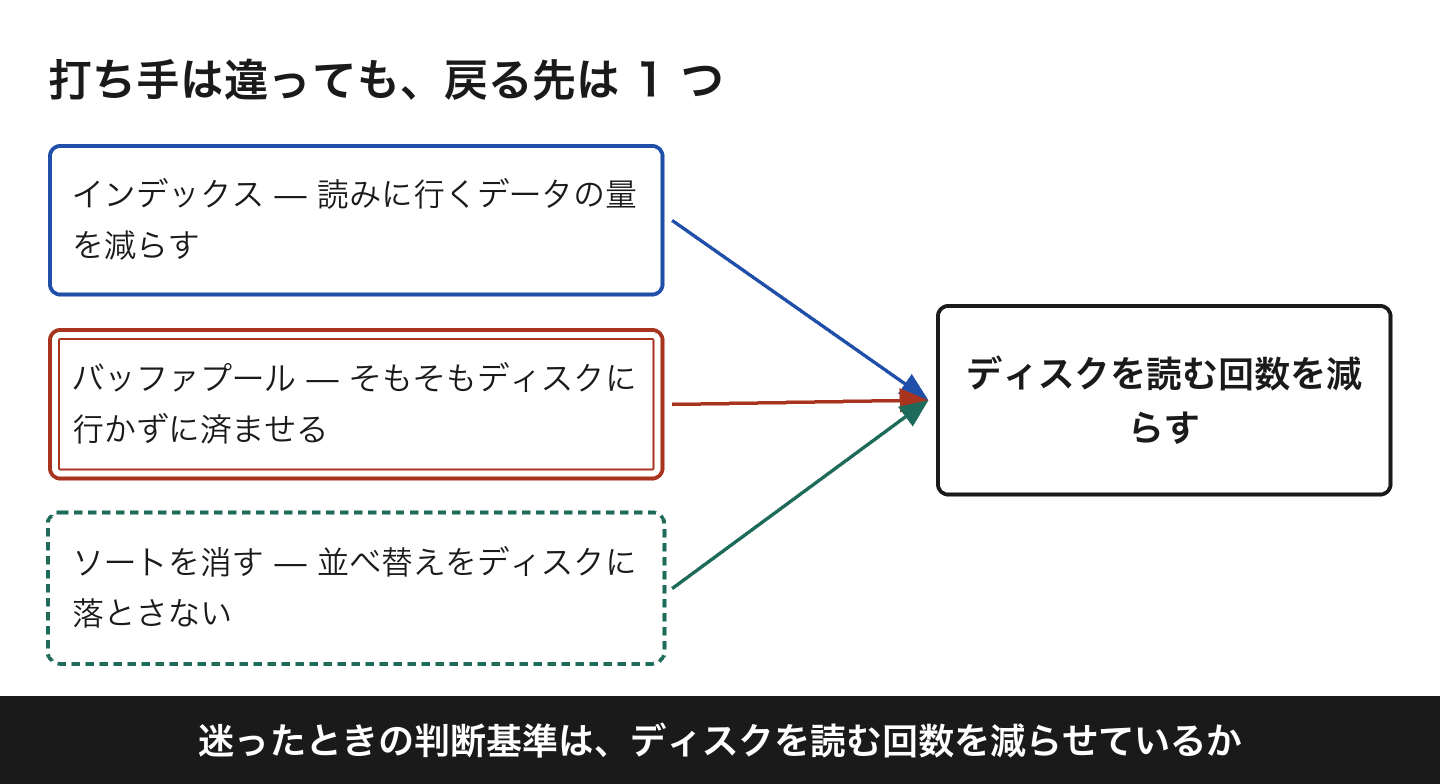
打ち手はいくつもあるが、判断基準は1つしかない。その変更は、ディスクを読む回数を減らせているか。 迷ったらここに戻る。
■ 参考
・Clustered and Secondary Indexes — MySQL 8.4 Reference Manual(https://dev.mysql.com/doc/refman/8.4/en/innodb-index-types.html)
・EXPLAIN Output Format — MySQL 8.4 Reference Manual(https://dev.mysql.com/doc/refman/8.4/en/explain-output.html)
・ORDER BY Optimization — MySQL 8.4 Reference Manual(https://dev.mysql.com/doc/refman/8.4/en/order-by-optimization.html)
・Nested-Loop Join Algorithms — MySQL 8.4 Reference Manual(https://dev.mysql.com/doc/refman/8.4/en/nested-loop-joins.html)
・The InnoDB Buffer Pool — MySQL 8.4 Reference Manual(https://dev.mysql.com/doc/refman/8.4/en/innodb-buffer-pool.html)
■ この記事を書いている会社について
株式会社MIRAILABS では、こうした検証を社内で持ち寄りながら、業務への組み込み方を詰めています。システム開発や AI を使った開発の進め方について、相談したいことがあればお問い合わせください。
MIRAILABS では一緒に働く仲間を募集しています。手を動かして確かめる進め方に心当たりのある方は、採用ページをご覧ください。
・採用情報(https://mirailabs.co.jp/recruit/)




